
Blackwell vs. Rubin: a nova geração da NVIDIA continua sendo um salto — só não o do pôster
A tabela comparativa que circula pelo LinkedIn usa os números originais do Rubin anunciados pela NVIDIA. Em setembro, a NVIDIA reduziu dois deles em silêncio. A vantagem sobre o Blackwell continua ampla — e o motivo pelo qual os números mudaram é a verdadeira história.
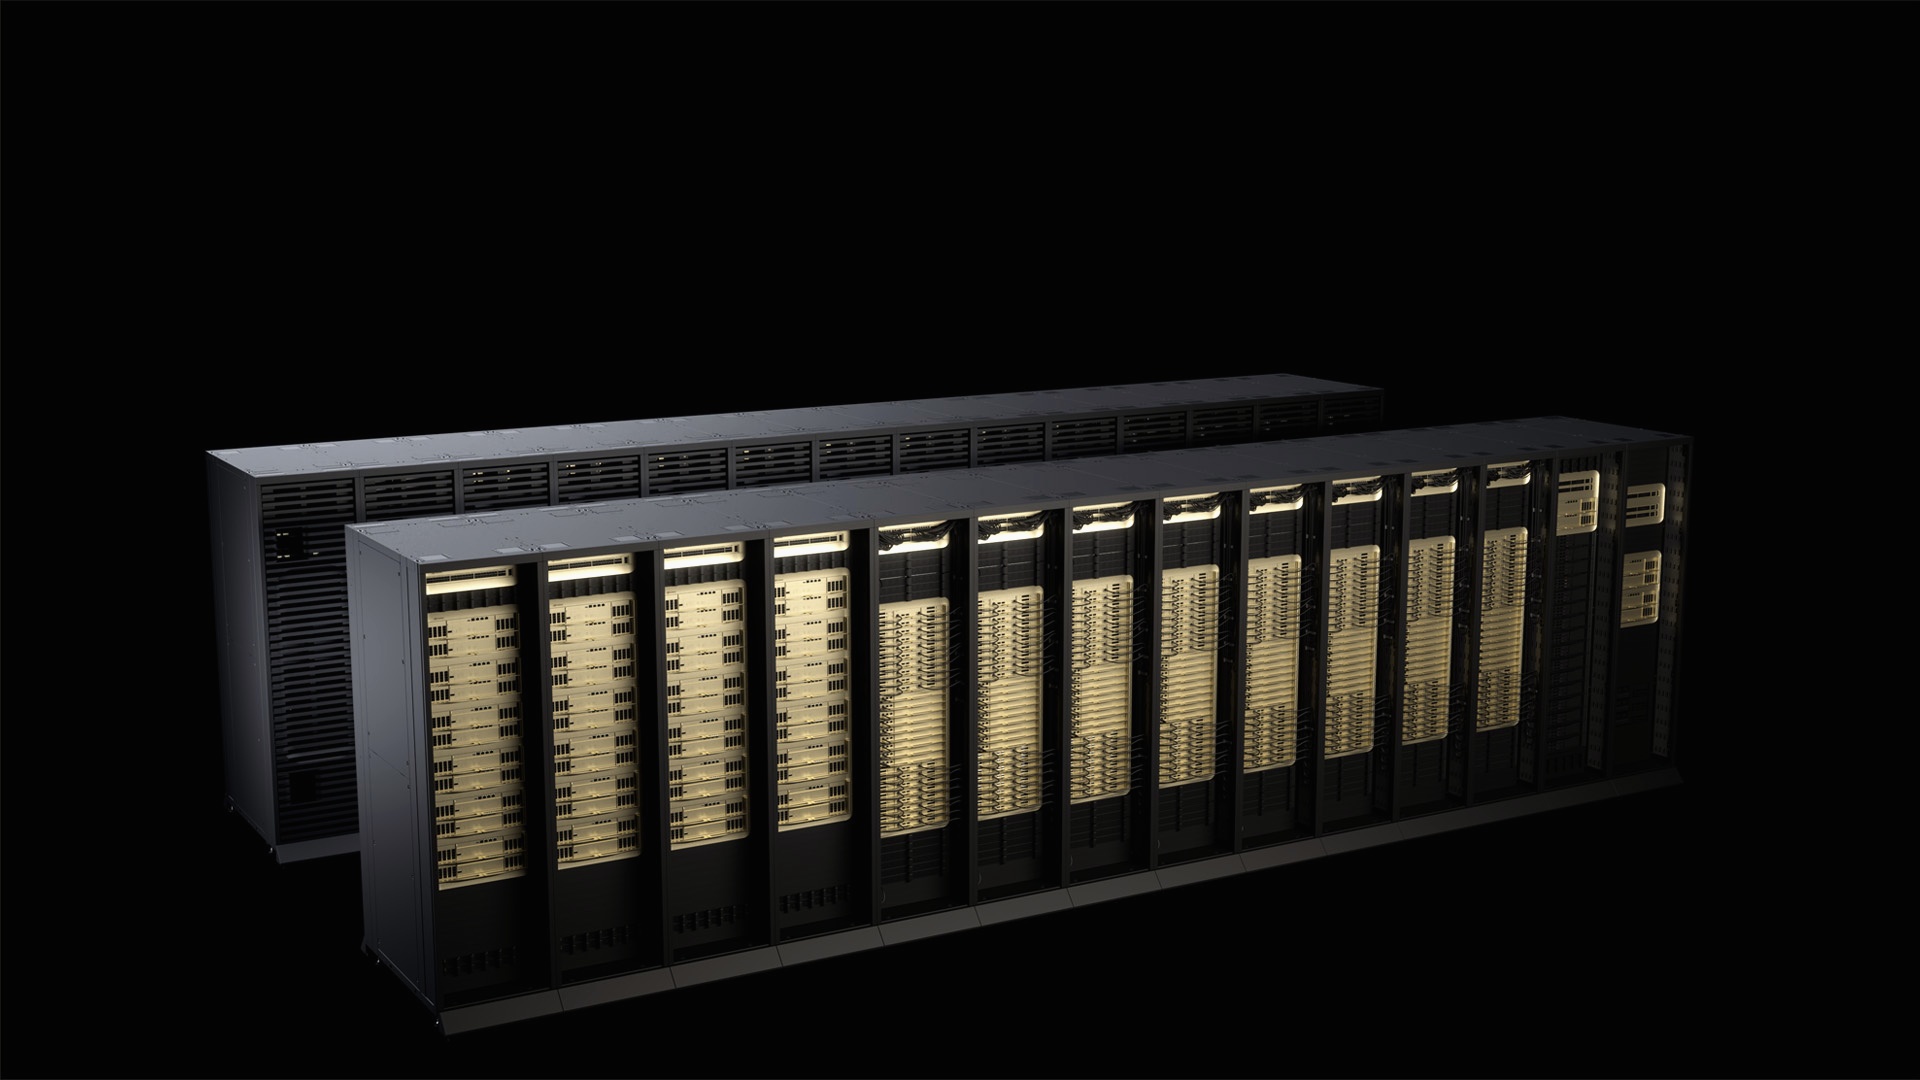
Foto: NVIDIA — Vera Rubin NVL72, imagem oficial de imprensa.
Uma tabela limpa, iluminada em verde, circula pelo LinkedIn: Blackwell à esquerda, Rubin à direita, e três linhas de números que parecem resolver a questão geracional de relance. A largura de banda de memória salta de 8 TB/s para 22 TB/s. O NVLink dobra. Caso encerrado.
Quase toda a tabela está correta. Mas os dois maiores números do Rubin já não são os que a própria NVIDIA publica — e a mudança aconteceu sem anúncio, sem post no blog e sem uma nota de rodapé que alguém devesse notar.
O que o pôster acerta
O lado do Blackwell na comparação é exato. O B200 carrega 192 GB de memória HBM3e por GPU — 180 GB expostos nas placas HGX de oito GPUs da NVIDIA — a 8 TB/s de largura de banda, com NVLink de quinta geração a 1,8 TB/s por GPU. O B300, vendido como Blackwell Ultra, eleva a capacidade para 288 GB de HBM3e (270 GB no formato HGX) e o cômputo denso em NVFP4 para 15 PFLOPS, enquanto a largura de banda e o NVLink ficam exatamente onde estavam. O Blackwell Ultra é uma atualização de memória e cômputo do mesmo silício, não uma arquitetura nova, e é a GPU mais potente da NVIDIA em envio em volume hoje.
A manchete do Rubin, como anunciada, era maior em todas as dimensões. A GPU Rubin combina dois dies de cômputo unidos pela interface NV-HBI da NVIDIA, 336 bilhões de transistores no total, com 288 GB de memória HBM4 distribuídos em oito pilhas. Os números de lançamento publicados pela NVIDIA prometiam até 22 TB/s de largura de banda de memória — 2,75 vezes a do Blackwell — e NVLink de sexta geração a 3,6 TB/s por GPU, o dobro da geração Blackwell. O cômputo de inferência foi fixado em 50 PFLOPS de NVFP4. A plataforma Vera Rubin construída em torno do chip foi declarada em plena produção na CES de janeiro de 2026, e a NVIDIA afirmou em 31 de maio de 2026 que entrava em rampa para a produção plena, com os envios de produção a partir do outono de 2026.
Os números que mudaram
Entre 1º e 11 de setembro de 2026, a NVIDIA editou as páginas de produto do Vera Rubin. As capturas arquivadas dessas páginas, apontadas primeiro pelo ITHome e reportadas pelo TweakTown, mostram a largura de banda HBM4 por GPU cortada de 22 TB/s para 19,2 TB/s — uma redução de cerca de 13% — e a largura de banda do NVLink 6 cortada de 3,6 TB/s para 3,0 TB/s por GPU, cerca de 17%. Os números em nível de rack se moveram junto: a largura de banda HBM4 agregada do Vera Rubin NVL72 agora marca 1.400 TB/s, e o HGX Rubin NVL8 de oito GPUs, a configuração que a maioria dos provedores de nuvem e das empresas realmente vai implantar, caiu de 176 TB/s para cerca de 130 TB/s de largura de banda de memória agregada.
A capacidade de memória não mudou: os 288 GB de HBM4 por GPU permanecem. Nem o número de inferência de 50 PFLOPS em NVFP4. O que mudou é a velocidade com que os dados se movem — e a NVIDIA não explicou por quê. As reportagens em torno da revisão apontam para a própria interface HBM4: uma taxa de dados por pino reduzida de 11,7 Gbps para 9,6 Gbps, possivelmente consequência do design de barramento e dos limites de sinalização da própria NVIDIA, e não das pilhas de memória, fornecidas por Micron, SK hynix e Samsung. Essa explicação continua sem confirmação da NVIDIA.
Por que a largura de banda é todo o argumento
A revisão importa porque a largura de banda de memória, e não o cômputo bruto, é a restrição que decide como essas máquinas rendem em produção. Modelos grandes passam boa parte do tempo esperando que os pesos e os dados de chave-valor cheguem da memória; o número de FLOPS de uma GPU descreve o que ela pode fazer nos momentos em que não está esperando. É por isso que a melhoria do B300 sobre o B200 foi sobretudo memória, e por isso o avanço do Rubin sobre o Blackwell sempre seria medido principalmente em terabytes por segundo.
Medido assim, o salto geracional sobrevive à correção. A 19,2 TB/s, uma GPU Rubin ainda move dados 2,4 vezes mais rápido que os 8 TB/s de uma GPU Blackwell. O NVLink a 3,0 TB/s ainda é 1,67 vez os 1,8 TB/s da geração Blackwell, através de uma malha NVL72 de 72 GPUs projetada para se comportar como uma única máquina. A direção do pôster está certa. Os números de destino são mais baixos que os impressos.
O corte também redesenha uma linha do mapa competitivo. Com a largura de banda de memória publicada do Rubin reduzida, o TweakTown observa que a plataforma Helios da AMD agora lidera em largura de banda de memória publicada — uma posição que, com os números originais, não estava ao seu alcance. Especificações publicadas não são resultados de benchmark, e os sistemas entregues resolverão a questão. Mas os fornecedores competem primeiro na página publicada, e essa página mudou.
O que observar
Blackwell e Blackwell Ultra continuam sendo a corrente principal implantada: são o que hoje compõe as instâncias em nuvem, os sistemas DGX e os pedidos empresariais. Os sistemas Rubin estão apenas começando a chegar, e as especificações que contarão serão as confirmadas no hardware entregue, não as de nenhuma página de produto — original ou revisada.
A tabela que circula esta semana não erra sobre para onde vai a infraestrutura de IA da NVIDIA. Erra sobre o quanto os números já avançaram — porque os números mudaram, em silêncio, em setembro, e quase ninguém atualizou o pôster.
𝐋𝐄𝐈𝐀 𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐔𝐈𝐓𝐀 𝐄𝐌 thebuyerspulse.com/pt/
Fontes
- Páginas de produto e materiais de arquitetura da NVIDIA para Vera Rubin e Blackwell Ultra (lidos em 16 de novembro de 2026): B200: 192 GB de HBM3e (180 GB em placas HGX) a 8 TB/s, NVLink 5 a 1,8 TB/s por GPU; B300 (Blackwell Ultra): 288 GB de HBM3e (270 GB em HGX), 15 PFLOPS densos de NVFP4; Rubin como anunciado: 288 GB de HBM4, até 22 TB/s, NVLink 6 a 3,6 TB/s por GPU, 336 bilhões de transistores, die duplo NV-HBI, 50 PFLOPS de inferência NVFP4.
- TweakTown, a partir de capturas do Wayback Machine das páginas de produto do Vera Rubin da NVIDIA de 1º e 11 de setembro de 2026 — a revisão apontada primeiro pelo ITHome: largura de banda HBM4 por GPU cortada de 22 para 19,2 TB/s; NVLink 6 cortado de 3,6 para 3,0 TB/s por GPU; largura de banda HBM4 agregada do Vera Rubin NVL72 agora em 1.400 TB/s; HGX Rubin NVL8 de 176 para cerca de 130 TB/s; taxa HBM4 por pino reportada de 11,7 → 9,6 Gbps, sem confirmação da NVIDIA.
- Declarações da NVIDIA: a plataforma Vera Rubin declarada em plena produção na CES (janeiro de 2026); rampa de produção confirmada em 31 de maio de 2026, com envios de produção a partir do outono de 2026.
- A tabela comparativa que motiva esta nota é de Farbod Alvandi (LinkedIn), com dados atribuídos à NVIDIA; sua imagem não é reproduzida aqui.
- Foto: NVIDIA — sistemas Vera Rubin NVL72, imagem oficial de imprensa publicada com o blog técnico da plataforma Vera Rubin da NVIDIA (janeiro de 2026).