
Blackwell vs. Rubin: la nueva generación de NVIDIA sigue siendo un salto — solo que no el del póster
La tabla comparativa que circula por LinkedIn usa las cifras originales de Rubin anunciadas por NVIDIA. En septiembre, NVIDIA bajó dos de ellas en silencio. La ventaja sobre Blackwell sigue siendo amplia — y el motivo por el que las cifras se movieron es la verdadera historia.
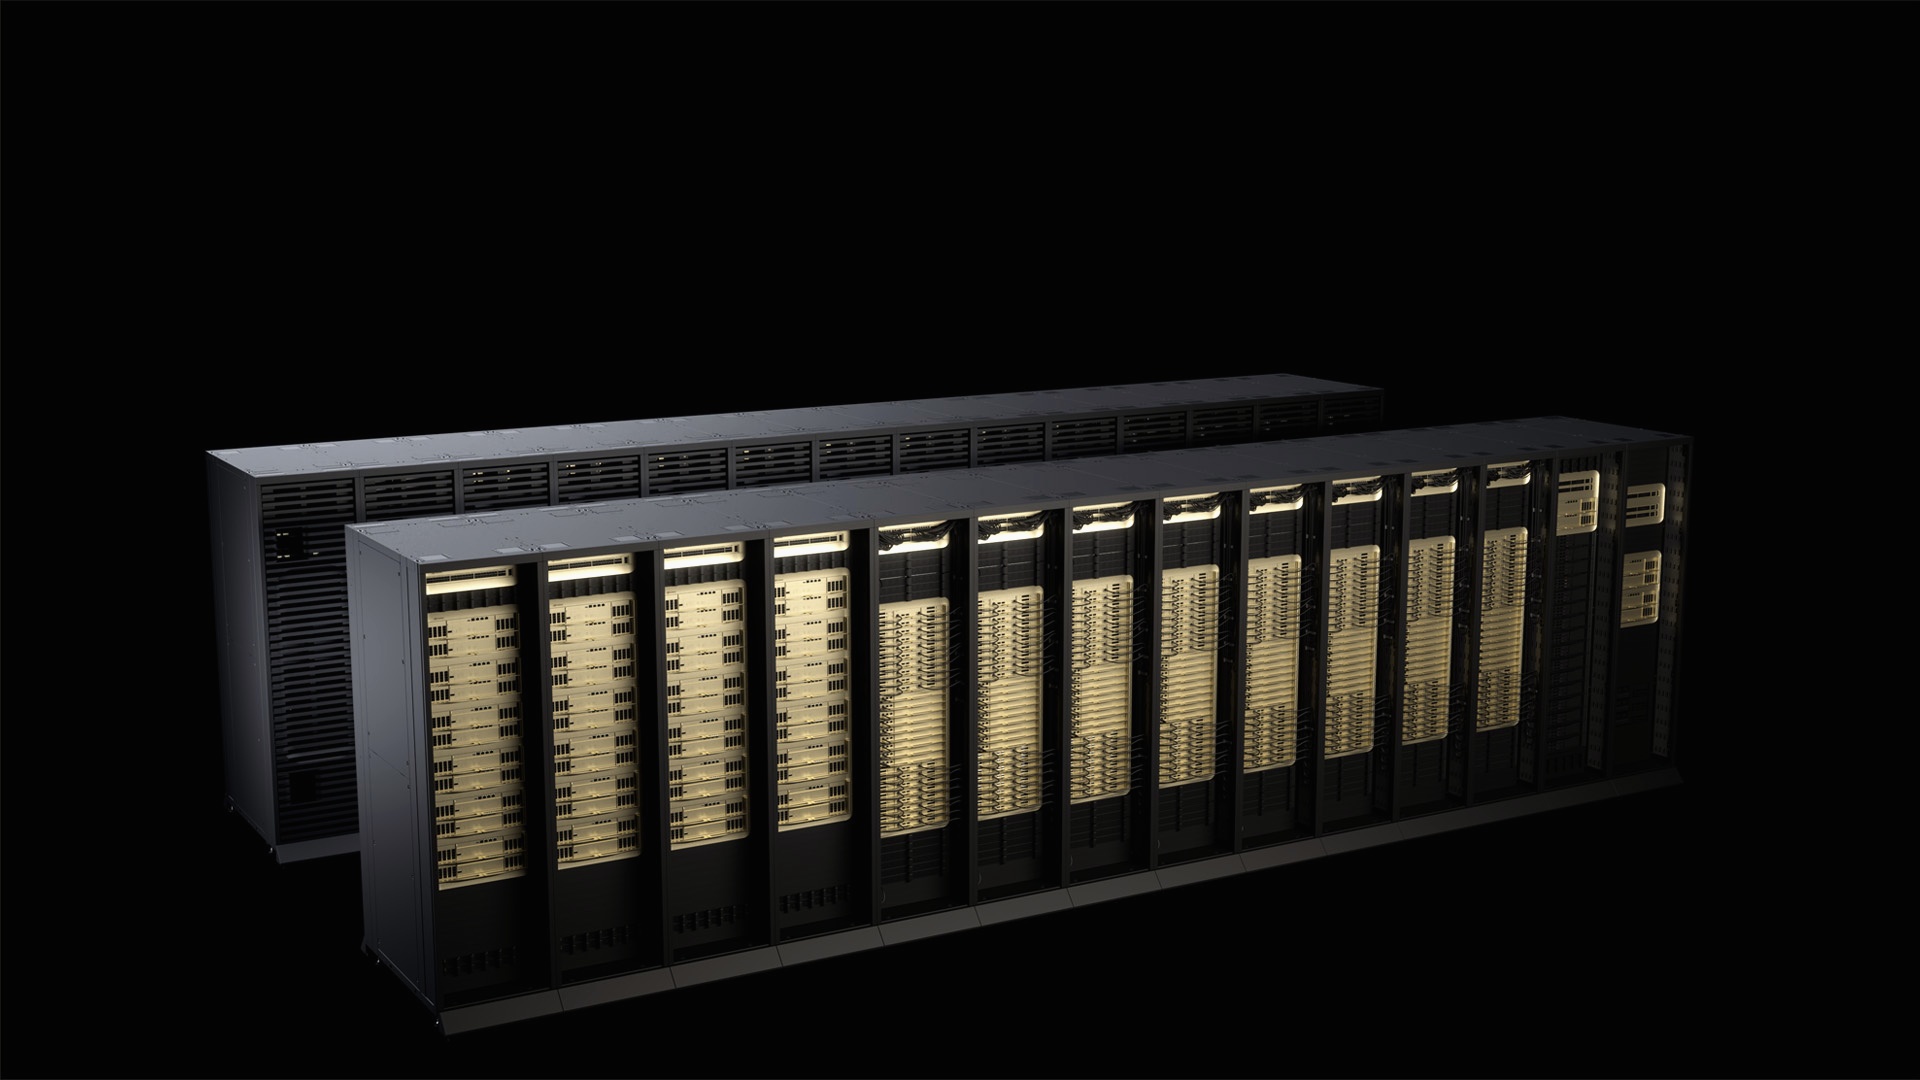
Foto: NVIDIA — Vera Rubin NVL72, imagen oficial de prensa.
Una tabla limpia, iluminada en verde, circula por LinkedIn: Blackwell a la izquierda, Rubin a la derecha, y tres filas de cifras que parecen resolver la cuestión generacional de un vistazo. El ancho de banda de memoria salta de 8 TB/s a 22 TB/s. NVLink se duplica. Caso cerrado.
Casi toda la tabla es correcta. Pero las dos cifras más grandes de Rubin ya no son las que la propia NVIDIA publica — y el cambio ocurrió sin anuncio, sin entrada de blog y sin una nota al pie que alguien debiera notar.
Lo que el póster acierta
El lado de Blackwell en la comparación es exacto. La B200 lleva 192 GB de memoria HBM3e por GPU — 180 GB expuestos en las placas HGX de ocho GPU de NVIDIA — a 8 TB/s de ancho de banda, con NVLink de quinta generación a 1,8 TB/s por GPU. La B300, vendida como Blackwell Ultra, eleva la capacidad a 288 GB de HBM3e (270 GB en formato HGX) y el cómputo denso en NVFP4 a 15 PFLOPS, mientras el ancho de banda y NVLink quedan exactamente donde estaban. Blackwell Ultra es una actualización de memoria y cómputo del mismo silicio, no una arquitectura nueva, y es la GPU de NVIDIA más potente que hoy se envía en volumen.
El titular de Rubin, tal como se anunció, era mayor en todas las dimensiones. La GPU Rubin combina dos dies de cómputo unidos por la interfaz NV-HBI de NVIDIA, 336.000 millones de transistores en total, con 288 GB de memoria HBM4 repartidos en ocho pilas. Las cifras de lanzamiento publicadas por NVIDIA prometían hasta 22 TB/s de ancho de banda de memoria — 2,75 veces el de Blackwell — y NVLink de sexta generación a 3,6 TB/s por GPU, el doble que la generación Blackwell. El cómputo de inferencia se fijó en 50 PFLOPS de NVFP4. La plataforma Vera Rubin construida alrededor del chip fue declarada en plena producción en el CES de enero de 2026, y NVIDIA dijo el 31 de mayo de 2026 que entraba en rampa hacia la producción plena, con los envíos de producción desde el otoño de 2026.
Las cifras que se movieron
Entre el 1 y el 11 de septiembre de 2026, NVIDIA editó las páginas de producto de Vera Rubin. Las capturas archivadas de esas páginas, señaladas primero por ITHome y reportadas por TweakTown, muestran el ancho de banda HBM4 por GPU recortado de 22 TB/s a 19,2 TB/s — una reducción de alrededor del 13 % — y el ancho de banda de NVLink 6 recortado de 3,6 TB/s a 3,0 TB/s por GPU, alrededor del 17 %. Las cifras a nivel de rack se movieron con ellas: el ancho de banda HBM4 agregado del Vera Rubin NVL72 ahora marca 1.400 TB/s, y el HGX Rubin NVL8 de ocho GPU, la configuración que la mayoría de los proveedores de nube y las empresas desplegarán de verdad, cayó de 176 TB/s a unos 130 TB/s de ancho de banda de memoria agregado.
La capacidad de memoria no cambió: los 288 GB de HBM4 por GPU se mantienen. Tampoco la cifra de inferencia de 50 PFLOPS en NVFP4. Lo que cambió es la velocidad a la que se mueven los datos — y NVIDIA no ha explicado por qué. Los reportes en torno a la revisión apuntan a la propia interfaz HBM4: una tasa de datos por pin reducida de 11,7 Gbps a 9,6 Gbps, posiblemente consecuencia del diseño de bus y los límites de señalización de la propia NVIDIA y no de las pilas de memoria, que suministran Micron, SK hynix y Samsung. Esa explicación sigue sin confirmación de NVIDIA.
Por qué el ancho de banda es todo el argumento
La revisión importa porque el ancho de banda de memoria, y no el cómputo bruto, es la restricción que decide cómo rinden estas máquinas en producción. Los modelos grandes pasan buena parte del tiempo esperando a que los pesos y los datos de clave-valor lleguen desde la memoria; la cifra de FLOPS de una GPU describe lo que puede hacer en los momentos en que no está esperando. Por eso la mejora de la B300 sobre la B200 fue sobre todo memoria, y por eso el avance de Rubin sobre Blackwell siempre iba a medirse principalmente en terabytes por segundo.
Medido así, el salto generacional sobrevive a la corrección. A 19,2 TB/s, una GPU Rubin sigue moviendo datos 2,4 veces más rápido que los 8 TB/s de una GPU Blackwell. NVLink a 3,0 TB/s sigue siendo 1,67 veces los 1,8 TB/s de la generación Blackwell, a través de una red NVL72 de 72 GPU diseñada para comportarse como una sola máquina. La dirección del póster es correcta. Las cifras de destino son más bajas que las impresas.
El recorte también redibuja una línea del mapa competitivo. Con el ancho de banda de memoria publicado de Rubin reducido, TweakTown señala que la plataforma Helios de AMD ahora lidera en ancho de banda de memoria publicado — una posición que, con las cifras originales, no estaba a su alcance. Las especificaciones publicadas no son resultados de benchmark, y los sistemas entregados resolverán la cuestión. Pero los fabricantes compiten primero en la página publicada, y esa página cambió.
Qué vigilar
Blackwell y Blackwell Ultra siguen siendo la corriente principal desplegada: son lo que hoy compone las instancias en la nube, los sistemas DGX y los pedidos empresariales. Los sistemas Rubin apenas empiezan a llegar, y las especificaciones que contarán serán las confirmadas en el hardware entregado, no las de ninguna página de producto — original o revisada.
La tabla que circula esta semana no se equivoca sobre hacia dónde va la infraestructura de IA de NVIDIA. Se equivoca sobre cuánto han avanzado ya las cifras — porque las cifras se movieron, en silencio, en septiembre, y casi nadie actualizó el póster.
𝐂𝐎𝐍𝐒𝐈𝐆𝐔𝐄 𝐋𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐈𝐒 𝐄𝐍 thebuyerspulse.com/es/
Fuentes
- Páginas de producto y materiales de arquitectura de NVIDIA para Vera Rubin y Blackwell Ultra (leídos el 16 de noviembre de 2026): B200: 192 GB de HBM3e (180 GB en placas HGX) a 8 TB/s, NVLink 5 a 1,8 TB/s por GPU; B300 (Blackwell Ultra): 288 GB de HBM3e (270 GB en HGX), 15 PFLOPS densos de NVFP4; Rubin tal como se anunció: 288 GB de HBM4, hasta 22 TB/s, NVLink 6 a 3,6 TB/s por GPU, 336.000 millones de transistores, doble die NV-HBI, 50 PFLOPS de inferencia NVFP4.
- TweakTown, a partir de capturas de Wayback Machine de las páginas de producto de Vera Rubin de NVIDIA del 1 y el 11 de septiembre de 2026 — la revisión señalada primero por ITHome: ancho de banda HBM4 por GPU recortado de 22 a 19,2 TB/s; NVLink 6 recortado de 3,6 a 3,0 TB/s por GPU; ancho de banda HBM4 agregado del Vera Rubin NVL72 ahora en 1.400 TB/s; HGX Rubin NVL8 de 176 a unos 130 TB/s; tasa HBM4 por pin reportada de 11,7 → 9,6 Gbps, sin confirmar por NVIDIA.
- Declaraciones de NVIDIA: la plataforma Vera Rubin declarada en plena producción en el CES (enero de 2026); rampa de producción confirmada el 31 de mayo de 2026, con envíos de producción desde el otoño de 2026.
- La tabla comparativa que motiva esta nota es de Farbod Alvandi (LinkedIn), con datos atribuidos a NVIDIA; su imagen no se reproduce aquí.
- Foto: NVIDIA — sistemas Vera Rubin NVL72, imagen oficial de prensa publicada con el blog técnico de la plataforma Vera Rubin de NVIDIA (enero de 2026).