
Gemini vence no voto dos usuários e Claude nos benchmarks: o mapa real da IA para 2026
Duas tabelas públicas da mesma semana contam duas histórias diferentes. Na preferência dos usuários, quem lidera é o Google: o Gemini 4 Carbon fecha a tabela de texto da Arena de 11 de novembro com 1.538 pontos. Na capacidade técnica medida por terceiros, quem lidera é a Anthropic: o Claude Fable 5.2, lançado em 9 de novembro, é o primeiro do índice da Artificial Analysis com 65 pontos. Entre um ranking e outro ficam as surpresas — um recém-chegado da Meta no top 5 do voto popular, os modelos da OpenAI na parte baixa da tabela de preferência e um topo inteiro renovado em poucos dias. Este artigo cruza as tabelas, explica cada surpresa com as fontes abertas e organiza os aplicativos de IA de 2026 em uma pirâmide por faixa de uso.
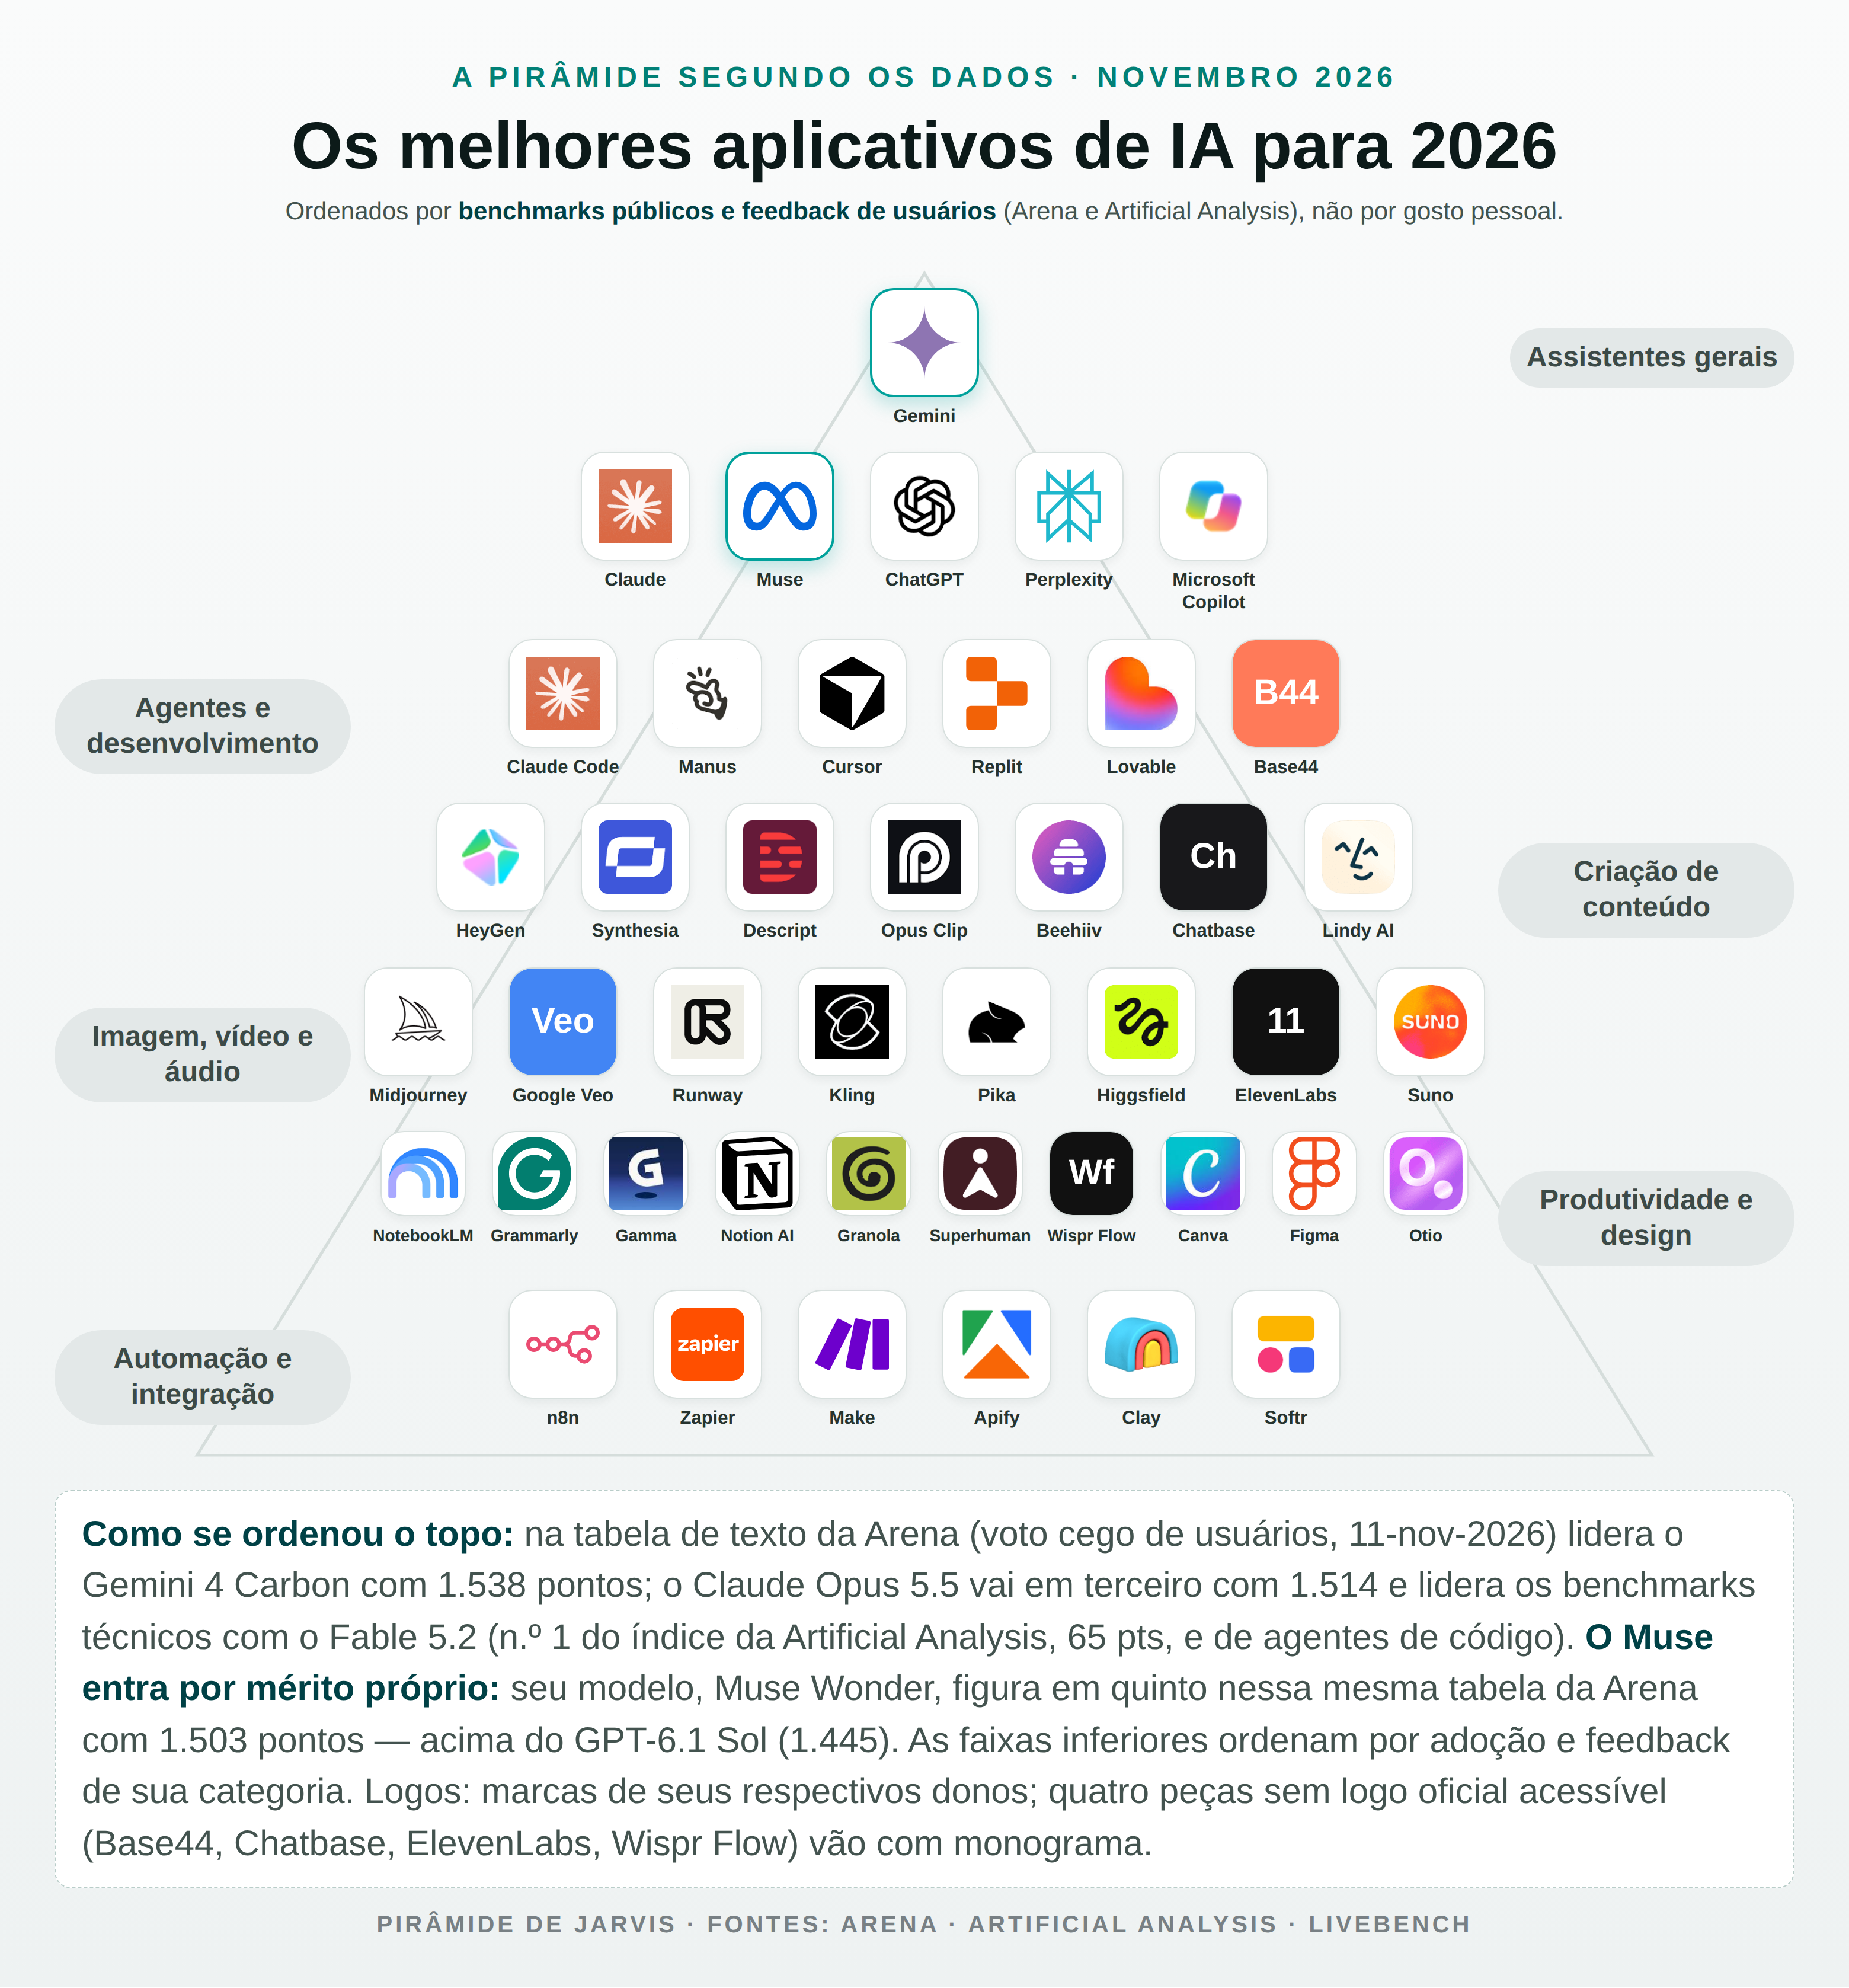
Figura: THE BUYER'S PULSE — pirâmide compilada para esta edição. Fontes de dados do topo: Arena (tabela de texto, 11-nov-2026) e Artificial Analysis (índice de inteligência), conforme a caixa de fontes ao final.
O dado duro primeiro. A classificação de texto da Arena — a antiga LMArena — atualizada em 11 de novembro de 2026 reúne 421 modelos e ordena as respostas que os usuários preferem em duelos cegos: duas respostas anônimas para a mesma pergunta, um voto, e uma pontuação calculada a partir de milhões desses confrontos. No topo dessa tabela está o Gemini 4 Carbon, do Google, com 1.538 pontos, seguido pelo Gemini 4 Argon, com 1.529. O Claude Opus 5.5, da Anthropic, é o terceiro, com 1.514, e o Claude Fable 5.1, o quarto, com 1.512. O quinto lugar é do Muse Wonder, da Meta, com 1.503 pontos, e o sexto, do Gemini 4 Hydrogen, com 1.502. Os modelos de fronteira da OpenAI aparecem muito mais abaixo na mesma tabela: o GPT-6.1 Sol soma 1.445 pontos e o GPT-6 Astra, 1.440.
Na leitura técnica, a ordem se inverte. O índice da Artificial Analysis — nove provas executadas pela própria empresa, nas mesmas condições para todos — é liderado pelo Claude Fable 5.2, apresentado em 9 de novembro, com 65 pontos; o Carbon é o segundo (60) e o Opus 5.5, o terceiro (59). O Fable 5.2 também lidera o LiveBench, o ARC-AGI-3 com arnês padrão, o índice de agentes de programação e as tabelas de desenvolvimento web e de agentes da Arena. Não há um vencedor único: há um vencedor por métrica.
As cinco surpresas da tabela — e o que as fontes dizem sobre cada uma
Surpresa 1: o Google no topo do voto dos usuários. O Gemini 4 Carbon lidera a Arena com 1.538 pontos, acima de Claude e de GPT. O que a fonte registra sobre o contexto: o modelo foi aberto ao público em 10 de novembro e é distribuído nos produtos do Google — na API paga, nos produtos empresariais, no aplicativo Gemini e no Modo IA da busca, com o plano Google AI Ultra. A própria fonte que compila a tabela faz, porém, uma ressalva metodológica importante: o Carbon soma 4.273 votos, contra 20.779 do Argon, e, com tão poucos votos, o seu intervalo de confiança ainda se sobrepõe ao do segundo colocado — o primeiro lugar existe, mas não está estatisticamente assegurado. Há ainda um fator de método documentado nas fontes: a Arena mede qual resposta agrada mais em uma conversa, e uma resposta longa e bem apresentada pode vencer mesmo contendo um erro. A posição do Gemini é, portanto, um dado de preferência registrada em duelos cegos, não uma medição de exatidão.
Surpresa 2: um recém-chegado da Meta no top 5. O Muse Wonder aparece em quinto na tabela de texto da Arena, com 1.503 pontos, acima do GPT-6.1 Sol (1.445). A família Muse é recente: o Muse Wonder Full foi apresentado em 12 de outubro. A posição varia conforme a configuração medida, e as fontes abertas mostram essa variação com números: uma segunda compilação da mesma tabela, também datada de 11 de novembro, registra o Muse Wonder em sua configuração máxima (max) em terceiro lugar, com 1.511 pontos. Diante das duas leituras, este artigo adota o número conservador — 1.503 pontos e o quinto lugar. A divergência tem explicação metodológica: a Arena pontua o mesmo modelo em vários ajustes de raciocínio (high, max) como linhas separadas, e cada compilação escolhe qual ajuste representar. Nos índices técnicos, a família é mais discreta: 50 pontos (Muse Wonder Full) e 44 (versão de API) no índice da Artificial Analysis — longe dos 65 do líder.
Surpresa 3: os modelos da OpenAI na parte baixa da tabela de preferência. O GPT-6.1 Sol (1.445) e o GPT-6 Astra (1.440) ficam longe do topo da Arena, e o Astra ocupa o 78.º lugar da classificação de texto. A queda é recente e está documentada: na atualização de 11 de novembro, os modelos da OpenAI perderam mais de 30 pontos — o Astra passou de 1.475 para 1.440 e o Sol, de 1.482 para 1.445. O contraste é que o mesmo Astra é o segundo no LiveBench e o terceiro no ARC-AGI-3 com arnês padrão. As fontes atribuem a dissociação ao objeto de cada medição: a Arena não mede quem raciocina melhor, e sim qual resposta os usuários preferem em uma janela de conversa. Adoção é uma terceira métrica, distinta das duas anteriores, e nenhuma das tabelas de preferência ou de benchmarks a mede — ponto retomado no cruzamento de rankings, mais abaixo. A pergunta que fica aberta, porque nenhuma fonte aberta consultada a responde, é quanto da queda de novembro se deve a mudanças nos modelos e quanto à composição dos votos do período.
Surpresa 4: a dissociação de Claude — terceiro no voto, primeiro na técnica. O Claude Opus 5.5 é o terceiro na Arena (1.514), praticamente empatado com o Fable 5.1 (1.512). Já nas medições técnicas, a Anthropic ocupa o topo em bloco: o Fable 5.2 lidera o índice da Artificial Analysis (65), o LiveBench (84,9 pontos na edição de 6 de novembro), o ARC-AGI-3 com arnês padrão (81,2%), o índice de agentes de programação (58,5 pontos, dentro do Claude Code) e as tabelas de desenvolvimento web (1.826 pontos) e de agentes da Arena. No Terminal-Bench 4.0, Fable 5.2 e Opus 5.5 empatam em primeiro, com 65,15% das tarefas resolvidas. A explicação que as fontes sustentam é de desenho de produto e de custo: a própria Anthropic recomenda começar pelo Opus 5.5 para a maioria das tarefas e reservar o Fable para as mais difíceis; e a vantagem técnica se paga — nas medições da Artificial Analysis, cada tarefa do índice custa, em esforço máximo, US$ 26,54 com o Fable 5.2, contra US$ 10,04 do Opus 5.5 e US$ 5,48 do Gemini 4 Carbon. O Fable 5.2 custa, por milhão de tokens, US$ 8 de entrada e US$ 40 de saída; o Carbon, US$ 2 e US$ 10 até 30 de novembro.
Surpresa 5: o topo inteiro foi renovado em dias. Os modelos que ocupam as primeiras posições foram lançados ou abertos ao público em uma janela de poucos dias: o Claude Fable 5.2 foi apresentado em 9 de novembro; o Gemini 4 Carbon foi aberto ao público em 10 de novembro; o Gemini 4 Hydrogen, o modelo rápido da família, foi apresentado em 12 de novembro. A consequência metodológica está registrada: um modelo novo só entra na Arena quando acumula votos suficientes, razão pela qual o Fable 5.2 ainda não aparece na tabela de texto de 11 de novembro. A ordem entre o quinto e o décimo lugares cabe em poucos pontos e, segundo a compilação, não é confiável nessa faixa, porque os intervalos se sobrepõem.
Como foi medido: metodologia e limites
Três famílias de medição sustentam este artigo, e elas não medem a mesma coisa. A primeira é a preferência: a Arena mostra duas respostas anônimas para a mesma pergunta e o usuário vota na que prefere; a pontuação resume com que frequência cada modelo vence esses duelos. Seu limite conhecido, documentado pelas fontes consultadas, é o viés de estilo — formato, extensão e apresentação influenciam o voto — somado à incerteza estatística dos modelos com poucos votos. A segunda família é a capacidade técnica composta: índices como o da Artificial Analysis, que executa suas próprias provas em condições iguais para todos, e o Capabilities Index da Epoch AI, agregado pela base DOA. Seu limite também está documentado: a nota depende do nível de esforço permitido ao modelo — o Opus 5.5 varia de 35 a 59 pontos conforme o esforço — e do arnês que o conecta à prova; no ARC-AGI-3, o Astra registra 62,7% com o arnês padrão e 99,9% com um arnês adaptado pelo fabricante, e só a primeira cifra é comparável. A terceira família é o uso: quanto um modelo é efetivamente utilizado. Nenhuma tabela de preferência ou de benchmark mede uso, e confundi-las é o erro que este cruzamento tenta evitar.
O cruzamento de rankings: consensos e divergências
Cruzadas as tabelas abertas nesta produção — Arena (texto, desenvolvimento web e agentes), Artificial Analysis, LiveBench, Epoch AI via DOA e o ranking de uso do OpenRouter —, dois consensos se sustentam. O primeiro: o topo é Gemini e Claude em quase todas as leituras. O Google lidera a preferência (Arena texto) e é segundo no índice técnico; a Anthropic lidera a técnica (Artificial Analysis, LiveBench, agentes de programação, desenvolvimento web e agentes da Arena) e coloca dois modelos entre os quatro primeiros da preferência. O segundo consenso é de proximidade: entre o primeiro e o oitavo da Arena há menos de 50 pontos, e os cinco primeiros do LiveBench cabem em um ponto e meio — as tabelas concordam que não há um líder destacado do pelotão.
As divergências são igualmente claras, e cada uma tem explicação metodológica. GPT: baixo em preferência, forte em técnica. O Astra é 78.º na Arena texto e, ao mesmo tempo, segundo no LiveBench (84,5) e terceiro no ARC-AGI-3 padrão (62,7%); no snapshot da Epoch AI agregado pela DOA, os modelos da OpenAI figuram no grupo de topo do índice de capacidade (GPT-6 Astra, 166,5; GPT-6.1 Sol, 166,1, em dados de 8 de outubro). A divergência se explica pelo objeto medido: preferência em conversa, de um lado; tarefas com resposta verificável, do outro. Muse Wonder: alto na Arena, discreto na técnica. Quinto em preferência (1.503; terceiro, com 1.511, na configuração máxima em outra compilação), o modelo da Meta soma 44 pontos na versão de API no índice da Artificial Analysis — 50 na variante Full — e 70,7 no LiveBench, abaixo dos líderes. Fable 5.2: líder técnico ausente da tabela de preferência. Sem votos suficientes até 11 de novembro, o modelo não consta da Arena texto — ausência que é um artefato do calendário de votação, não uma posição. Quanto ao uso: o ranking do OpenRouter ordena modelos pelos tokens processados em sua API, com dados até 17 de novembro de 2026, e a própria página adverte que tokens não medem usuários, gasto nem qualidade; nesta produção, a lista nominal de uso não pôde ser extraída do texto da página, de modo que a coluna de uso da tabela abaixo fica sem dado, em vez de preenchida com estimativas.
| Modelo | Arena texto (11-nov) | Artificial Analysis | LiveBench (6-nov) | Epoch ECI via DOA (8-out) | Uso (OpenRouter) |
|---|---|---|---|---|---|
| Gemini 4 Carbon (Google) | 1.538 · 1.º | 60 · 2.º | 83,5 · 4.º | sem dado | sem dado |
| Gemini 4 Argon (Google) | 1.529 · 2.º | 50 | 77,7 · 8.º | sem dado | sem dado |
| Claude Opus 5.5 (Anthropic) | 1.514 · 3.º | 59 · 3.º | 83,4 · 5.º | 167,3 | sem dado |
| Claude Fable 5.2 (Anthropic) | sem dado — ainda sem votos suficientes | 65 · 1.º | 84,9 · 1.º | sem dado | sem dado |
| Muse Wonder (Meta) | 1.503 · 5.º | 44 (API) · 50 (Full) | 70,7 | sem dado | sem dado |
| GPT-6.1 Sol (OpenAI) | 1.445 | 55 | 81,4 · 6.º | 166,1 | sem dado |
| GPT-6 Astra (OpenAI) | 1.440 · 78.º | 57 · 4.º | 84,5 · 2.º | 166,5 | sem dado |
Leitura da tabela: «sem dado» significa que a fonte indicada não registra o modelo — no caso da Epoch, porque o snapshot agregado pela DOA é de outubro, anterior aos lançamentos de novembro; no caso do uso, porque a lista nominal do OpenRouter não foi extraível nesta produção. A coluna da Arena de imagem fica fora do cruzamento pelo mesmo critério: nenhuma fonte aberta nesta produção trouxe a tabela de imagem da Arena com números verificáveis.
A pirâmide: os aplicativos, faixa a faixa
Modelos são o motor; aplicativos são o que as equipes usam. A pirâmide da figura ordena o topo pelos dados acima — Gemini no vértice, pela liderança na preferência; Claude, Muse, ChatGPT, Perplexity e Microsoft Copilot na faixa dos assistentes gerais — e organiza as faixas seguintes por categoria de uso, a partir do mapa de aplicativos compilado para esta edição.
Assistentes gerais. É a faixa dos modelos de fronteira em forma de produto: Gemini, Claude, Muse, ChatGPT, Perplexity e Microsoft Copilot. Aqui mandam os dados das seções anteriores — preferência, índice técnico e ecossistema de acesso: o Gemini chega pelos produtos do Google, o Copilot pelo ambiente Microsoft e o ChatGPT como a interface associada aos modelos GPT, cuja posição nesta pirâmide reflete sua presença como assistente, não sua pontuação de preferência de novembro.
Agentes e desenvolvimento. Claude Code, Manus, Cursor, Replit, Lovable e Base44. É a faixa com benchmark próprio mais sólido: nas tabelas da Arena de 15 de novembro, o desenvolvimento web é liderado pelo Fable 5.2 (1.826) e a tabela de agentes, pelo mesmo modelo, com o Opus 5.5 em segundo e o Carbon em terceiro; no índice de agentes de programação da Artificial Analysis, o Fable 5.2 dentro do Claude Code marca 58,5 pontos, e o Muse Wonder Full, 54,5, em sexto. O custo mediano por tarefa de agente, publicado pela Arena, inverte a ordem de atratividade: US$ 1,35 com o Carbon, US$ 5,65 com o Opus 5.5 e US$ 9,02 com o Fable 5.2.
Criação de conteúdo. HeyGen, Synthesia, Descript, Opus Clip, Beehiiv, Chatbase e Lindy AI: vídeo com avatares, edição por texto, cortes automáticos, newsletters, chatbots e agentes de fluxo.
Imagem, vídeo e áudio. Midjourney, Google Veo, Runway, Kling, Pika, Higgsfield, ElevenLabs e Suno: geração e edição de imagem, vídeo generativo, voz sintética e música. As fontes abertas desta produção não trouxeram uma tabela de imagem da Arena com números verificáveis, de modo que nenhum líder numérico é afirmado aqui para texto-para-imagem.
Produtividade e design. NotebookLM, Grammarly, Gamma, Notion AI, Granola, Superhuman, Wispr Flow, Canva, Figma e Otio: pesquisa sobre documentos, escrita assistida, apresentações, notas de reunião, e-mail, ditado e design. A escolha depende menos do ranking do modelo e mais do encaixe no fluxo de cada equipe.
Automação e integração. n8n, Zapier, Make, Apify, Clay e Softr: conexão entre aplicativos, extração de dados, enriquecimento de contatos e construção de ferramentas internas sem código. Nesta faixa, o modelo de IA é um componente entre conectores; o critério de compra é a confiabilidade da integração e o custo por execução, não a pontuação em benchmarks.
O que isso significa para quem compra tecnologia
A leitura prática é direta. Para conversa geral, a tabela de preferência é o sinal disponível — Gemini e Claude no topo, com intervalos sobrepostos que desaconselham trocar de fornecedor por poucos pontos. Para código e agentes, contam os índices técnicos e o custo por tarefa: o Fable 5.2 lidera as medições, e o Carbon entrega tarefas de agente por uma fração do custo mediano. E preço por token não é custo por tarefa: modelos que raciocinam mais gastam mais tokens, conforme o esforço configurado. E nenhuma faixa se decide por uma tabela só: preferência, capacidade e uso são três perguntas diferentes, com respostas diferentes em novembro de 2026.
Nota editorial de transparência. Este ranking inclui a Muse, plataforma cujo modelo — o Muse Wonder, da Meta — executa o fluxo de trabalho desta redação. A posição atribuída à Muse na pirâmide e neste texto vem da tabela pública da Arena citada acima (1.503 pontos, quinto lugar, na leitura conservadora), e não de escolha editorial.
Fontes
- Metix — «Benchmarks de IA hoy: ranking actualizado (noviembre 2026)», dados de 16-nov-2026: tabela de texto da Arena (atualização de 11-nov-2026), índice da Artificial Analysis, LiveBench (edição de 6-nov-2026), ARC-AGI-3, Terminal-Bench 4.0, índice de agentes de programação e tabelas de desenvolvimento web e de agentes da Arena (15-nov-2026), com preços e datas de lançamento. https://metix.ninja/modelos/benchmarks-ia/
- Trendy Tech Tribe — «Ranking de modelos de IA: quién es el n.º 1, a diario»: tabela de texto da LMArena de 11-nov-2026 com votos e margens (inclui Muse Wonder (max) em 3.º, com 1.511) e a metodologia dos duelos cegos e dos ajustes de raciocínio. https://trendytechtribe.com/es/ai/ai-model-rankings
- DOA — «Modelos de IA»: ranking DOA como média normalizada de Arena e Epoch AI; cifras da Epoch AI (Capabilities Index) de 8-out-2026 agregadas na página. https://www.doa-ia.es/es/modelos
- OpenRouter — «LLM Rankings»: metodologia do ranking de uso por tokens processados, com dados até 17-nov-2026; a página adverte que tokens não medem usuários, gasto nem qualidade. https://openrouter.ai/rankings