
Gemini manda en el voto de los usuarios y Claude en los benchmarks: el mapa real de la IA para 2026
En la clasificación de texto de Arena, actualizada el 11 de noviembre de 2026, Gemini 4 Carbon, de Google, lidera con 1.538 puntos. En el índice de inteligencia de Artificial Analysis manda otro: Claude Fable 5.2, de Anthropic, presentado el 9 de noviembre, con 65 puntos, cinco por encima del propio Carbon. No hay un ganador único: hay dos coronas distintas, y la distancia entre ambas es la historia.
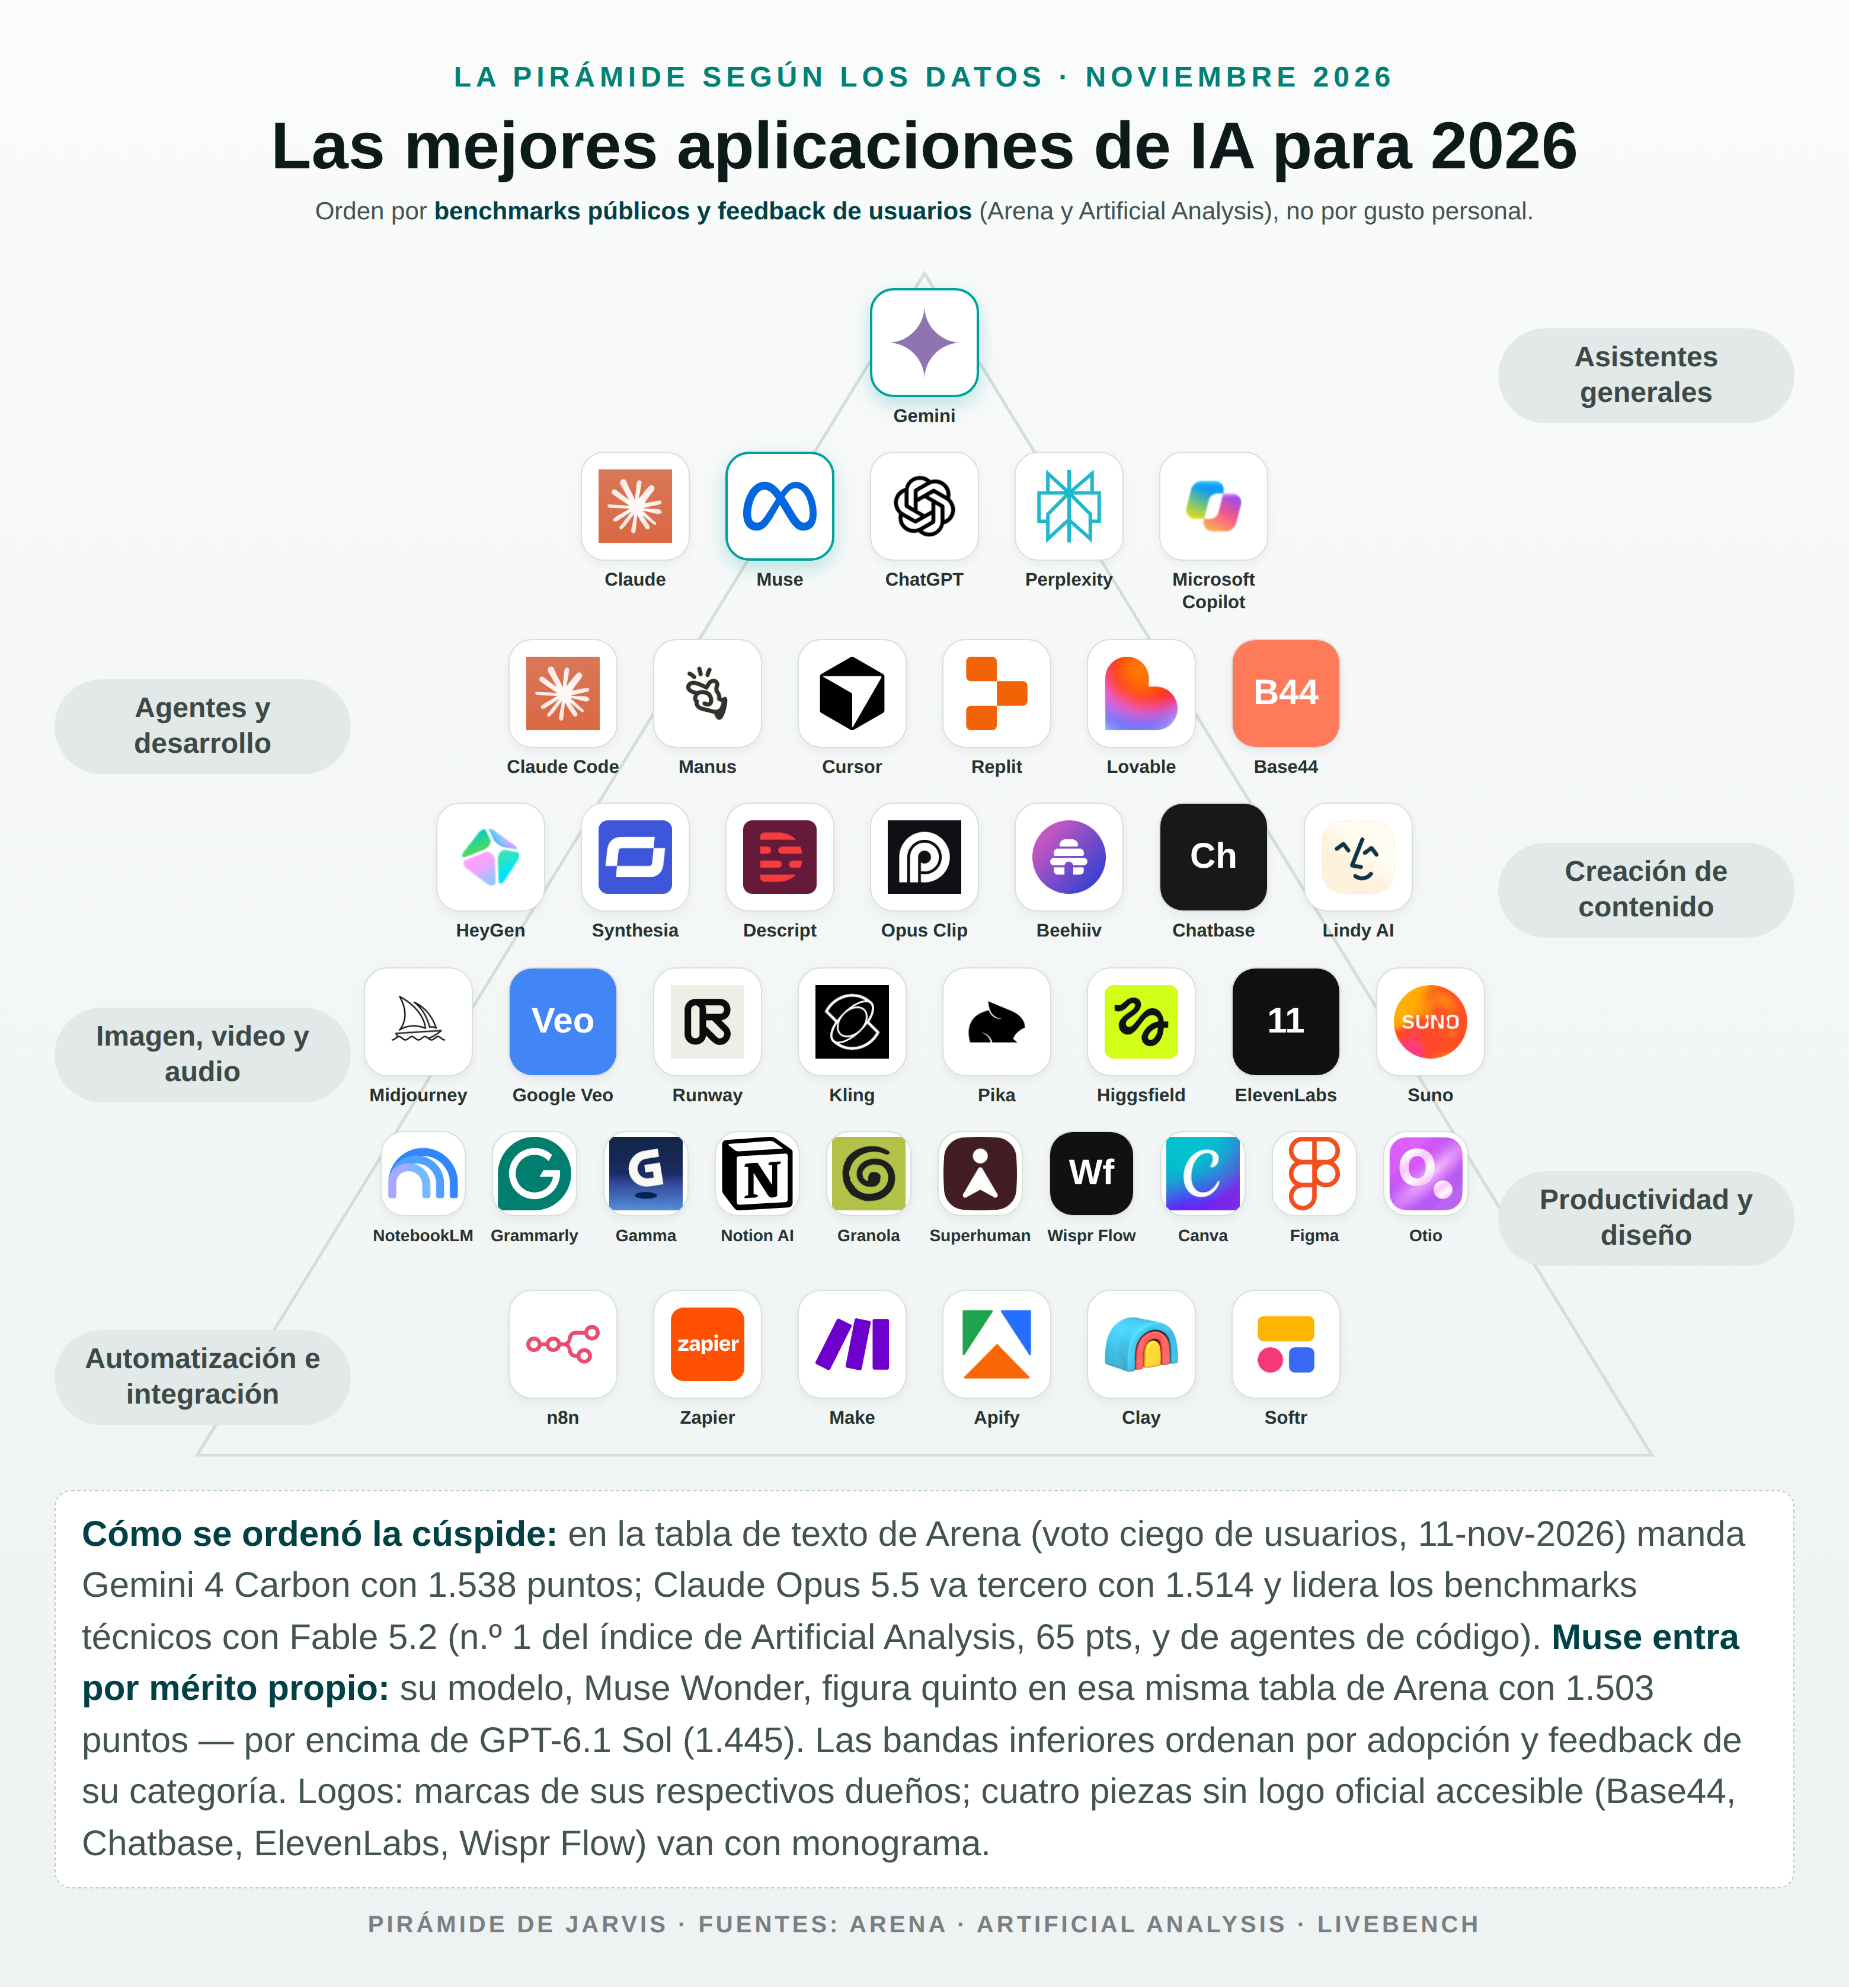
Gráfico: THE BUYER'S PULSE. Datos: clasificación de texto de Arena (actualización del 11 de noviembre de 2026) e índice de Artificial Analysis, reunidos y contrastados por Metix con datos al 16 de noviembre de 2026.
La foto de noviembre de 2026 no se parece a la de hace un año. La parte alta de la tabla de preferencia la ocupan modelos lanzados en cuestión de días, un recién llegado de Meta se cuela entre los cinco primeros por encima de los modelos de OpenAI, y el modelo que gana casi todas las pruebas técnicas ni siquiera aparece todavía en la tabla de voto popular. Este artículo ordena ese mapa con las cifras públicas disponibles, explica cómo se obtuvo cada una y señala dónde coinciden los rankings independientes y dónde se separan.
Cómo se midió: tres métricas que no miden lo mismo
Arena (antes LMArena) muestra a cada visitante dos respuestas anónimas a la misma pregunta y le pide votar la mejor. Con millones de esos duelos a ciegas calcula una puntuación de tipo Bradley-Terry, la misma familia matemática que el Elo del ajedrez: la cifra indica con qué frecuencia gana un modelo frente al resto. Es, por construcción, una medida de preferencia: qué respuesta gusta más en una conversación. Metix advierte su límite conocido: una respuesta larga y bien presentada puede ganar el duelo aunque contenga un error. Arena publica además los votos y el margen de incertidumbre de cada modelo; cuando los márgenes se solapan, la diferencia no es estadísticamente sólida.
Artificial Analysis funciona al revés: es una empresa independiente que ejecuta ella misma nueve pruebas, en las mismas condiciones para todos los modelos, y resume el resultado en un índice de inteligencia (versión 5.0 desde el 28 de octubre). Ahí no vota nadie: hay respuestas correctas e incorrectas. Epoch AI, cuyo Capabilities Index agrega DOA-IA junto a Arena, pertenece a la misma familia de medición técnica. LiveBench, en su edición 2.0 del 6 de noviembre, pone a los modelos a hacer trabajo real con herramientas — tareas de agente, arreglo de fallos en código, uso de aplicaciones web, investigación, documentos — y corrige de forma automática. Y existe una tercera métrica, distinta de ambas: la adopción. OpenRouter publica un ranking por tokens procesados a través de su API y advierte en su propia página que ese volumen no mide usuarios, ni gasto, ni calidad. En esta producción se abrió esa página y se verificó su metodología, pero la lista de modelos por volumen no formaba parte del texto accesible, así que no se cita ninguna cifra de uso: donde el cruce lo requería, la casilla queda como «sin dato».
Con esas tres lentes — preferencia, capacidad técnica y uso — la tabla se lee de otra manera. Y aparecen las sorpresas.
La tabla de Arena: el voto de los usuarios
La clasificación de texto de Arena recoge 421 modelos en su actualización del 11 de noviembre. Así queda su parte alta, según los datos reunidos por Metix al 16 de noviembre:
| Puesto | Modelo | Puntos Arena (texto) |
|---|---|---|
| 1.º | Gemini 4 Carbon (Google) | 1.538 |
| 2.º | Gemini 4 Argon (Google) | 1.529 |
| 3.º | Claude Opus 5.5 (Anthropic) | 1.514 |
| 4.º | Claude Fable 5.1 (Anthropic) | 1.512 |
| 5.º | Muse Wonder (Meta) | 1.503 |
| 6.º | Gemini 4 Hydrogen (Google) | 1.502 |
| 7.º | Gemini 3.8 Flash (Google) | 1.500 |
| — | GPT-6.1 Sol (OpenAI) | 1.445 |
| 78.º | GPT-6 Astra (OpenAI) | 1.440 |
Entre el primero y el séptimo hay 38 puntos: una cabeza compacta y con el orden fino frágil. Metix señala que Carbon suma 4.273 votos y que su intervalo de confianza todavía se solapa con el de Argon (20.779 votos), de modo que el primer puesto no está estadísticamente asegurado. Otra instantánea de la misma tabla, la de Trendy Tech Tribe (11 de noviembre), da cifras ligeramente distintas — Carbon (high) con 1.526 y Muse Wonder (max) tercero con 1.511 — porque Arena puntúa por separado cada configuración de razonamiento. Este artículo usa la serie de Metix, una fila por modelo, y cita a Muse Wonder en su valor conservador: 1.503 puntos, quinto puesto.
Las cinco sorpresas de la tabla, y qué las explica
Primera: Google ocupa la cúspide del voto. Tres de los seis primeros puestos de Arena son de la familia Gemini 4 (Carbon, Argon y Hydrogen), por encima de Claude y de GPT. La explicación que sostienen las fuentes es de calendario y de método: la familia es nueva — Argon se abrió al público el 13 de octubre, Carbon el 10 de noviembre y Hydrogen se presentó el 12 de noviembre — y Arena no ordena por capacidad demostrada en un examen, sino por duelos de preferencia en conversación. En ese terreno la cabeza de noviembre es de Google, con el matiz estadístico ya citado: Carbon y Argon están dentro del margen del otro.
Segunda: Muse Wonder, el recién llegado de Meta, es quinto con 1.503 puntos, por encima de GPT-6.1 Sol (1.445). Meta presentó Muse Wonder Full el 12 de octubre. Su puesto en Arena convive con una posición muy distinta en la medición técnica: en Artificial Analysis, Muse Wonder Full obtiene 50 puntos y la versión disponible en la API, 44. La divergencia es la que separa las dos métricas: el voto a ciegas premia la respuesta que el usuario prefiere en el chat; el índice técnico puntúa aciertos en pruebas ejecutadas por un tercero.
Tercera: los modelos de ChatGPT quedan relegados en preferencia. GPT-6.1 Sol marca 1.445 puntos y GPT-6 Astra, 1.440, en el puesto 78. Metix registra el movimiento: en la actualización del 11 de noviembre, los modelos de OpenAI pierden más de 30 puntos (Astra pasa de 1.475 a 1.440; Sol, de 1.482 a 1.445). Las fuentes consultadas documentan la caída, pero no publican su causa; esa pregunta queda abierta. Lo que sí está medido es el contraste: el mismo Astra es segundo en LiveBench (84,5 puntos), tercero en ARC-AGI-3 con el arnés estándar (62,7 %) y cuarto en Artificial Analysis (57). La lectura metodológica de Metix es directa: Arena no mide quién razona mejor, sino qué respuesta gusta más en una conversación. La preferencia y la capacidad son dos tablas distintas — y la adopción, cuánto se usa cada producto, es una tercera que ninguna de estas clasificaciones mide.
Cuarta: la disociación de Claude. Anthropic es tercero en el voto de usuarios con Claude Opus 5.5 (1.514) y, a la vez, primero en casi todas las mediciones técnicas con Claude Fable 5.2: 65 puntos en Artificial Analysis (cinco más que Carbon), primero en LiveBench (84,9), primero en ARC-AGI-3 con el arnés estándar (81,2 %), primero en el índice de agentes de programación de Artificial Analysis dentro de Claude Code (58,5) y primero en las tablas de desarrollo web (1.826 puntos) y de agentes de Arena. La explicación está en qué mide cada tabla: las que gana Fable 5.2 corrigen tareas con respuesta verificable o sesiones reales de agente completadas; la de texto de Arena vota conversaciones. Fable 5.2 está disponible desde el primer día en la API y en los planes de pago de Claude, a 8 dólares por millón de tokens de entrada y 40 de salida.
Quinta: la cabeza de la tabla tiene días de vida. Fable 5.2 se presentó el 9 de noviembre; Carbon se abrió al público el 10; Hydrogen se presentó el 12. La clasificación de texto de Arena se actualizó el 11, y en ella Fable 5.2 todavía no aparece: Arena clasifica un modelo cuando acumula suficientes votos en duelos a ciegas, y Trendy Tech Tribe lo lista entre los recién lanzados «aún sin clasificar», junto a los GPT-6.2 presentados el 17 de noviembre. Es decir: el líder técnico del momento no tiene aún nota en la tabla de preferencia, no por demérito, sino porque esa tabla necesita votos que todavía no existen.
El cruce de rankings: consensos y divergencias
Cruzadas las tablas abiertas para esta producción — Arena, Artificial Analysis, LiveBench y el Epoch Capabilities Index que agrega DOA-IA — el consenso es nítido: la cabeza es un asunto de dos casas, Google y Anthropic. Carbon es primero en Arena y segundo en Artificial Analysis; Opus 5.5 está entre los cinco primeros en Arena (3.º), Artificial Analysis (3.º, 59 puntos) y LiveBench (5.º, 83,4); y en la foto anterior, la de octubre, el ranking compuesto de DOA-IA — media normalizada de Arena y Epoch con datos del 2 y el 8 de octubre — ya ponía a Claude Opus 5.5 primero, con un índice Epoch (ECI) de 167,3. Las divergencias son igual de claras, y cada una tiene su explicación metodológica:
| Modelo | Arena texto | Artificial Analysis | LiveBench | Epoch (ECI, vía DOA-IA) | Uso (OpenRouter) |
|---|---|---|---|---|---|
| Gemini 4 Carbon | 1.538 (1.º) | 60 (2.º) | 83,5 (4.º) | sin dato | sin dato |
| Claude Fable 5.2 | sin dato (aún no clasificado) | 65 (1.º) | 84,9 (1.º) | sin dato | sin dato |
| Claude Opus 5.5 | 1.514 (3.º) | 59 (3.º) | 83,4 (5.º) | 167,3 | sin dato |
| Muse Wonder | 1.503 (5.º) | 44 (versión API); 50 (Wonder Full) | 70,7 | sin dato | sin dato |
| GPT-6.1 Sol | 1.445 | 55 | 81,4 (6.º) | 166,1 | sin dato |
| GPT-6 Astra | 1.440 (78.º) | 57 (4.º) | 84,5 (2.º) | 166,5 | sin dato |
Datos de Arena, Artificial Analysis y LiveBench según Metix (16 de noviembre de 2026); índice Epoch según DOA-IA (datos del 2 y el 8 de octubre de 2026): una foto anterior, útil para el contraste y no comparable punto por punto con la de noviembre. La columna de uso queda «sin dato» por lo explicado en la metodología.
La divergencia mayor es la de GPT-6 Astra: puesto 78 en preferencia y segundo en trabajo real medido por LiveBench, con un ECI de 166,5, el segundo más alto de la lista de DOA-IA. La segunda es la de Muse Wonder: quinto en preferencia, 44–50 puntos en el índice técnico. La tercera es una ausencia: Fable 5.2, líder técnico, sin fila en la tabla de voto. Ninguna exige elegir un ranking «verdadero»: cada tabla responde a su pregunta — qué gusta, qué acierta, qué completa tareas — y el puesto se mueve porque la pregunta cambia.
La pirámide, banda por banda
Sobre esos modelos se construyen las aplicaciones. La pirámide del gráfico ordena las herramientas por bandas de uso, con la cúspide que marcan los datos: Gemini arriba, y en la banda de asistentes generales, Claude, Muse, ChatGPT, Perplexity y Microsoft Copilot.
Asistentes generales. Es la banda de la conversación diaria: Claude, Muse — la aplicación construida sobre Muse Wonder —, ChatGPT, Perplexity y Microsoft Copilot. Aquí manda la tabla de preferencia de Arena, cuyos primeros puestos están separados por decenas de puntos con márgenes solapados: en el uso cotidiano pesan tanto la aplicación y su precio como la nota del modelo.
Agentes y desarrollo. Claude Code, Manus, Cursor, Replit, Lovable y Base44 trabajan sobre los modelos en modo agente: ejecutan tareas en varios pasos. Es la banda donde las mediciones de noviembre son más favorables a Anthropic: Fable 5.2 lidera el índice de agentes de programación dentro de Claude Code (58,5) y la tabla de desarrollo web de Arena (1.826), y empata con Opus 5.5 en Terminal-Bench 4.0 (65,15 % de tareas resueltas). En sesiones reales de agente, Arena pone a Fable 5.2 primero con el puesto asegurado — su margen no se cruza con el de ningún otro, según Metix —, seguido de Opus 5.5 y de Carbon.
Creación de contenido. HeyGen, Synthesia, Descript, Opus Clip, Beehiiv, Chatbase y Lindy AI convierten los modelos en producción: video con avatares, edición, clips, boletines, chatbots y agentes de flujo. No hay una tabla pública única que las ordene; su rendimiento depende del modelo subyacente que cada una integra, y por eso el cruce de rankings de modelos es la referencia disponible.
Imagen, video y audio. Midjourney, Google Veo, Runway, Kling, Pika, Higgsfield, ElevenLabs y Suno forman la banda generativa. Las fuentes abiertas para este artículo no incluyen una tabla de imagen verificable con la que ordenarlas — la clasificación de imagen de Arena no pudo confirmarse en esta producción — así que la banda se presenta sin puestos internos antes que con cifras no contrastadas.
Productividad y diseño. NotebookLM, Grammarly, Gamma, Notion AI, Granola, Superhuman, Wispr Flow, Canva, Figma y Otio aplican los modelos a documentos, reuniones, presentaciones y diseño. Su valor se mide en el flujo de trabajo que ahorran, variable que ningún benchmark de modelos captura.
Automatización e integración. n8n, Zapier, Make, Apify, Clay y Softr conectan los modelos con el resto del software de la empresa. Aquí la variable decisiva que sí aparece en las tablas es el costo por tarea: en las sesiones de agente de Arena, el costo mediano es de 9,02 dólares con Fable 5.2, 5,65 con Opus 5.5 y 1,35 con Carbon; automatizar en volumen con el modelo más capaz cuesta varias veces más que con el más rápido.
Qué significa para quien compra tecnología
La primera consecuencia es que «el mejor modelo» no existe como respuesta única: existe el mejor modelo para una pregunta. Para conversación y redacción con usuarios, la referencia es Arena, y su cabeza de noviembre es Gemini. Para tareas con respuesta verificable — código, agentes, trabajo largo en terminal — las referencias son Artificial Analysis, LiveBench y Terminal-Bench, y su cabeza es Claude. Para presupuestos por API, la tabla de precios cambia el orden: Fable 5.2 cuesta 8 dólares por millón de tokens de entrada y 40 de salida, y Artificial Analysis calcula que cada tarea de su índice le sale a 26,54 dólares con esfuerzo máximo, frente a 10,04 de Opus 5.5 y 5,48 de Carbon. Carbon, además, tiene precio de lanzamiento de 2 y 10 dólares hasta el 30 de noviembre; desde el 1 de diciembre pasará a 4 y 20.
La segunda consecuencia es de método: toda cifra sin su configuración es incompleta. El mismo modelo cambia de puesto según el nivel de esfuerzo de razonamiento — en Arena, las configuraciones «high» y «max» son filas distintas — y según la herramienta que lo envuelve, como muestra el índice de agentes de programación, que mide modelo y aplicación juntos. Y la tercera es de calendario: con la cabeza renovada en días, un despliegue cerrado a un solo proveedor queda expuesto al siguiente lanzamiento; la tabla, en concreto, se mueve cada semana.
Nota de transparencia
Este ranking incluye a Muse, la plataforma cuyo modelo, Muse Wonder, hace funcionar el flujo de trabajo de esta redacción. El puesto de Muse Wonder citado en el artículo — quinto, con 1.503 puntos — procede de la tabla pública de Arena reunida por Metix, no de una elección editorial, y su posición en el índice técnico de Artificial Analysis (44 puntos la versión de API; 50, Wonder Full) se publica en el mismo artículo.
Fuentes
- Metix — «Benchmarks de IA hoy: ranking actualizado (noviembre 2026)», datos al 16 de noviembre de 2026: Arena (texto, desarrollo web, agentes); Artificial Analysis (inteligencia y agentes de programación); LiveBench 2.0; Terminal-Bench 4.0; ARC-AGI-3; precios y costos por tarea. https://metix.ninja/modelos/benchmarks-ia/
- Trendy Tech Tribe — «Ranking de modelos de IA: quién es el n.º 1, a diario»: tabla de texto de LMArena del 11 de noviembre de 2026, por configuración de razonamiento, con márgenes del 95 % y modelos recién lanzados aún sin clasificar. https://trendytechtribe.com/es/ai/ai-model-rankings
- DOA-IA — «Modelos de IA»: ranking compuesto (media normalizada de Arena y Epoch AI) con datos de Arena del 2 de octubre y de Epoch AI del 8 de octubre de 2026, e índice Epoch Capabilities Index (ECI) por modelo. Leído en https://www.doa-ia.es/es/modelos
- OpenRouter — «LLM Rankings»: página abierta y metodología verificada (ranking por tokens procesados a través de su API; datos de uso hasta el 17 de noviembre de 2026; la propia página advierte que el volumen no mide usuarios ni gasto ni calidad). La lista de modelos por volumen no formaba parte del texto accesible en esta producción y no se cita ninguna cifra de uso. https://openrouter.ai/rankings
- Gráfico de la pirámide: THE BUYER'S PULSE, construido con las clasificaciones públicas citadas arriba.