
Microsoft 365 cai no mundo todo: o e-mail do Outlook, o Teams e o Copilot fora do ar
O Microsoft 365 sofre nesta quinta-feira uma queda global. As caixas de correio do Exchange Online ficaram inacessíveis por vários métodos de conexão, e a incidência principal da Microsoft (MO1550821) atinge também o Teams, o SharePoint Online, o Microsoft 365 Copilot e o Defender XDR; a do e-mail é a EX1550543 no centro de administração.
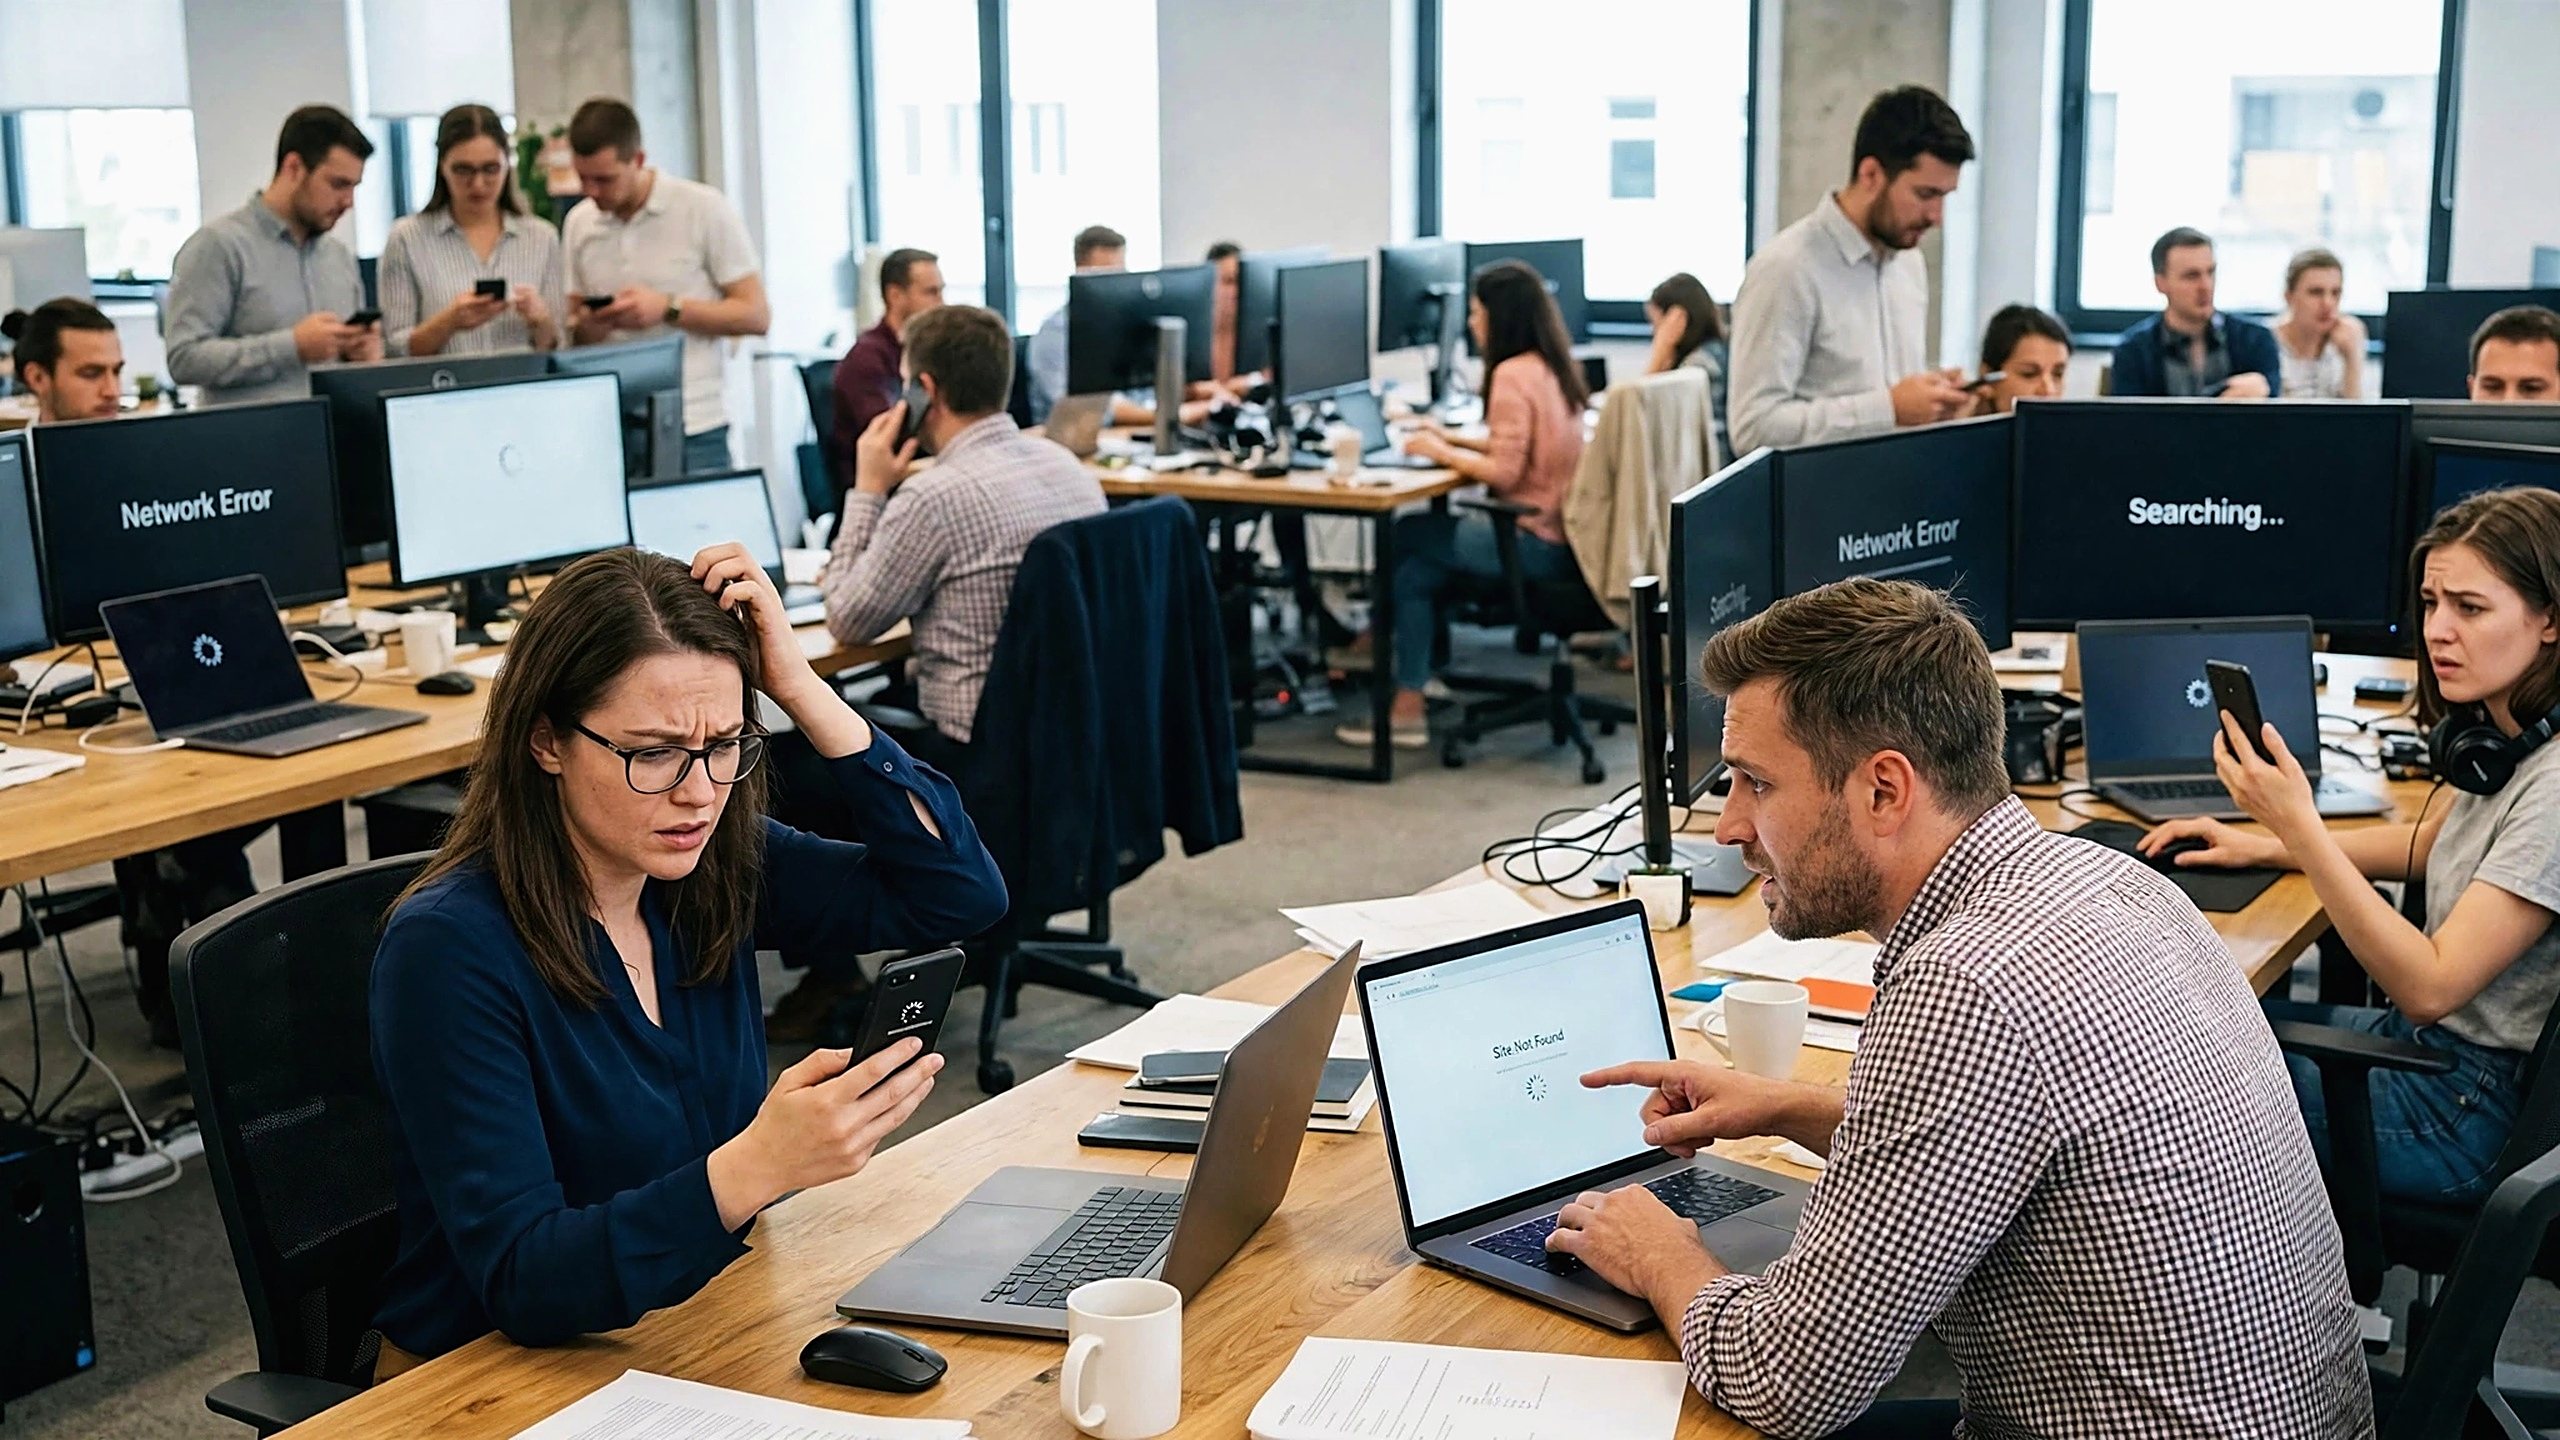
Ilustração: The Buyer's Pulse.
Começou nas Américas e a Microsoft confirmou depois que pode afetar usuários de qualquer região. No Downdetector, os relatos de usuários sobre o Outlook atingiram um pico de cerca de 130.000 por volta das 13h10 ET, e os do Microsoft 365 rondaram os 46.000–47.000.
A causa, segundo a própria Microsoft — que corrigiu sua primeira explicação —, não foi um aumento de tráfego: uma quantidade de servidores ficou fora de serviço de forma inesperada e saturou a infraestrutura restante. A empresa está testando uma mudança de configuração ligada aos servidores que falham nas suas verificações automáticas de saúde, reinicia os afetados, mantém todas as implantações em pausa e redistribui o tráfego.
Até o fechamento desta edição não há hora estimada de restabelecimento e a queda segue aberta. É a segunda falha do dia: o Teams já sofreu outra pela manhã, já resolvida.
Como a queda se desenrolou
Segundo a Microsoft, o incidente do Microsoft 365 começou às 13h26 ET, embora seus engenheiros já investigassem desde antes os relatos de problemas de conexão com as caixas de correio do Exchange Online nas Américas. O primeiro aviso cobria o serviço de e-mail; o incidente maior, MO1550821, confirmou depois que os clientes podiam ficar sem conexão com Exchange Online, Microsoft Teams, SharePoint Online, Microsoft 365 Copilot e Microsoft Defender XDR.
A explicação foi mudando ao longo da tarde. A Microsoft apontou primeiro uma carga elevada em parte da sua infraestrutura em várias regiões. Depois corrigiu a si mesma em uma atualização no X: a carga elevada não era fruto de um aumento de tráfego, mas de uma quantidade de servidores que ficou fora de serviço de forma inesperada, sobrecarregando a infraestrutura restante, e a empresa trabalhava para devolvê-los ao serviço com segurança. Em outras palavras: primeiro desapareceu capacidade, e a demanda que restou caiu sobre menos máquinas.
A mitigação seguiu esse diagnóstico. A Microsoft pausou todas as implantações, redistribuiu o tráfego de conexão pela sua infraestrutura mundial, afastou mais tráfego dos sistemas afetados e começou a reiniciar os servidores caídos para recuperar capacidade. E reconheceu que, embora os primeiros relatos tenham vindo das Américas, o problema podia afetar a conectividade do Microsoft 365 de usuários de qualquer região.
Para quem tentava continuar trabalhando, a falha era fácil de descrever: caixas de correio que não abriam por nenhuma das portas habituais. O aviso de e-mail da Microsoft cobre o acesso por vários métodos de conexão, e por isso alternar entre o aplicativo web, o cliente de desktop e o telefone não adiantava: o problema estava atrás de todos eles, no próprio serviço, não em um aplicativo específico.
A curva pública da queda vem do Downdetector, que reúne os relatos enviados pelos próprios usuários. As reclamações dispararam na tarde de quinta-feira em Outlook, Microsoft 365, Teams, Copilot, Azure, OneDrive e Microsoft Store. Os relatos do Outlook atingiram um pico de quase 130.000 por volta das 13h10 ET, e os do Microsoft 365 passaram de 47.000 logo depois; o Teams chegou a cerca de 4.600 relatos e o Copilot a cerca de 6.000. Às 15h20 ET, cerca de 69.000 pessoas ainda relatavam problemas com o Outlook, e outras 31.000 com o Microsoft 365. Esses números medem quanta gente enviou um relato, não quantos usuários foram afetados: a Microsoft não divulgou um número de clientes afetados.
A segunda falha do dia
A queda da tarde não foi a primeira. Horas antes, na mesma quinta-feira, outro incidente separado do Teams — registrado como TM1550488 — durou das 9h45 às 10h53 ET e afetou usuários da América do Norte e da América do Sul com atrasos e falhas no envio de mensagens, erros ao criar ou atualizar conversas e problemas para recuperar as mensagens do chat. A Microsoft atribuiu essa falha a uma contenção de recursos dentro da sua infraestrutura, que elevou a utilização até o serviço não conseguir processar as solicitações de mensagens normalmente, e afirma que ela foi totalmente resolvida. A empresa não disse se os dois incidentes estão relacionados.
A curva, hora a hora
Atrás do pico arredondado há um número exato. Segundo a cobertura ao vivo do USA Today, o Downdetector registrou exatamente 128.874 relatos sobre o Outlook às 13h09 ET. A partir daí, a curva caiu em etapas, e são as etapas — mais do que o pico — que contam a história. Às 13h50 ET, os relatos do Outlook tinham caído para 92.914 e os do Microsoft 365 para cerca de 37.000: uma melhora clara, mas ainda um incidente em massa por qualquer critério, menos de uma hora depois do pior momento.
Depois, a queda desacelerou: os relatos se acomodaram em um platô relativo entre 15h30 e 16h ET, com pouco mais de 58.000 relatos do Outlook ainda chegando, e o Microsoft 365 desenhou a mesma forma um degrau abaixo, com cerca de 19.000 relatos por volta das 15h55. As últimas leituras do acompanhamento ao vivo do USA Today, pouco antes das 17h ET, colocavam o Outlook em cerca de 49.000 relatos e o Microsoft 365 em cerca de 18.800.
Para um gerente de operações, essa forma — queda parcial rápida, platô e descida lenta — é a cronologia prática do incidente: a recuperação era real, mas desigual, e dezenas de milhares de usuários continuavam relatando horas depois do pico. Uma curva em queda não é um serviço restabelecido: é evidência sobre a direção, não a hora de encerrar a emergência.
Como a Microsoft trabalhou na solução
A mitigação também tem seu relógio. Às 13h07 ET, a Microsoft confirmou em uma publicação no X, registrada pelo USA Today, que o problema podia afetar a conectividade do Microsoft 365 de usuários de qualquer região. Às 13h48 acrescentou que tinha começado a redistribuir o tráfego de conexão pela sua infraestrutura mundial mais ampla para equilibrar a carga.
Em outra atualização reproduzida pelo USA Today, a própria Microsoft disse isso sem rodeios: estava perseguindo agressivamente todos os caminhos para reduzir o impacto, tinha pausado todas as implantações, estava afastando mais tráfego da infraestrutura afetada e reiniciava os servidores caídos para devolvê-los ao serviço.
O avanço mais claro veio por volta das 16h ET. A Microsoft afirmou que tinha validado um método alternativo de verificação de saúde do serviço, que permitiu que um subconjunto dos servidores afetados voltasse ao serviço com sucesso, e que agora aplicava essa mudança de forma mais ampla, além de preparar sistemas de recuperação automática para detectar e reiniciar os servidores que não respondessem. Na mesma faixa de horário, a empresa disse que alguns servidores já tinham sido devolvidos ao serviço e que trabalhava para aplicar a correção em escala maior.
Às 16h40 ET, o trabalho ainda era de validação, não de encerramento: a Microsoft disse que reiniciava e validava ativamente os servidores afetados para devolvê-los ao serviço com segurança, explorando ainda formas de acelerar o processo. Mesmo então, sua página de status continuava mostrando vários serviços — Outlook, Teams, SharePoint, Copilot e Defender — com interrupções.
O que a Microsoft não disse
No fechamento desta edição, três perguntas seguem abertas. Por que uma quantidade de servidores ficou fora de serviço ao mesmo tempo ainda não tem uma resposta publicada: a empresa corrigiu primeiro o que a falha não era — um aumento de tráfego — antes de explicar o que ela era. Também não foi revelado quantos clientes foram afetados. E em nenhum momento foi dado um horário de restabelecimento, de modo que as empresas que esperavam pelo serviço não tiveram um relógio oficial para planejar, apenas a sequência de atualizações.
O silêncio teve ainda um segundo canal. O USA Today observa que a Microsoft não respondeu imediatamente ao seu pedido de comentários adicionais, e o BleepingComputer conta que contatou a empresa com perguntas sobre a queda e que atualizaria sua matéria se recebesse uma resposta. Além das publicações de status, não houve uma versão mais completa disponível.
O que isso significa para as empresas que operam sobre o Microsoft 365
Releia a lista de serviços afetados e o que aparece é, na prática, o sistema operacional da empresa: a caixa de correio, a camada de reuniões e chat, o armazenamento de arquivos, o assistente de IA e — com o Defender XDR na lista — parte do próprio console de segurança. Quando tudo isso vive em um único fornecedor, uma falha de infraestrutura deixa de ser um chamado de TI e vira uma pausa da empresa inteira, no meio do dia útil e em todas as regiões ao mesmo tempo. Que a ferramenta de detecção da equipe de segurança apareça na lista de afetados, justo na tarde em que ela é mais necessária, é o detalhe que os gerentes de risco vão sublinhar.
Os detalhes do incidente, enquanto isso, vivem onde a maioria dos funcionários não consegue ver: os avisos completos estão no centro de administração do Microsoft 365, sob EX1550543 e MO1550821, visíveis para os administradores de cada organização. Para todos os outros, há uma caixa de correio que não abre. Um fornecedor que pausa todas as suas próprias implantações está dizendo aos clientes, na prática, que a estabilidade vem antes de qualquer outra mudança: uma prioridade razoável, e também uma confirmação da escala do que quebrou.
É essa a decisão que esta queda coloca sobre a mesa dos gerentes de TI: não se o Microsoft 365 é a suíte certa — para a maioria das empresas essa pergunta já está respondida —, mas quanto do dia de trabalho deveria depender de uma única nuvem sem um canal de reserva para e-mail e reuniões, e o que o plano de continuidade diz quando a resposta honesta é "tudo". Dois incidentes em um mesmo dia, sem vínculo declarado entre eles e sem uma causa raiz completa até agora, é exatamente o tipo de evidência que pertence à próxima conversa de renovação e de SLA.
Um detalhe da atualização das 16h amplia o panorama operacional: segundo o USA Today, a página de status de saúde da Microsoft incluía então, entre os serviços afetados, Outlook, Teams, SharePoint, Copilot, Defender, To Do e Purview. To Do e Purview não figuravam na lista principal com a qual esta matéria abre: o primeiro é a camada de tarefas a partir da qual muitas equipes organizam o dia; o segundo, parte das ferramentas de conformidade. A pegada de uma queda assim raramente se limita aos aplicativos dos quais as pessoas reclamam primeiro.
A recuperação, quando veio, também chegou serviço a serviço, e não de uma vez. Pouco antes das 17h ET, o USA Today informou que o Copilot parecia estar de volta on-line para a grande maioria dos usuários, enquanto os relatos do Outlook continuavam em torno de 49.000. Para o gerente que decide quando retirar o plano alternativo, essa é a decisão que importa: cada serviço se julga pela sua própria evidência, porque a suíte não volta como um bloco único — e a ferramenta de segurança continuava figurando como interrompida naquela hora.
A divisão da informação tem ainda seu próprio custo de gestão. O El País anota que, para o público geral, a Microsoft remete à sua página de status, enquanto os detalhes completos do incidente ficam no centro de administração. Isso transforma os administradores de cada empresa em tradutores entre o registro do fornecedor e a experiência de todos os outros: o que o funcionário vê é uma página de status e uma caixa de correio que não abre, e a qualidade da mensagem interna depende inteiramente de quão bem a equipe de TI narra uma cronologia que não controla.
Quando o e-mail de milhões de pessoas depende de uma única nuvem, uma queda assim não é só mais um incidente técnico: é a jornada de trabalho de meio mundo ficando em pausa.
Fontes
- El País (12 nov. 2026): a Microsoft confirma uma queda global do Microsoft 365 — caixas do Exchange Online inacessíveis por vários métodos de conexão e o Copilot entre os serviços afetados; a primeira explicação da empresa apontou carga elevada em parte da sua infraestrutura, sem hora de restabelecimento.
- BleepingComputer (12 nov. 2026), 'Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide': o aviso MO1550821 que cobre Exchange Online, Microsoft Teams, SharePoint Online, Microsoft 365 Copilot e Defender XDR; a correção da Microsoft — a carga elevada não vinha de um aumento de tráfego, mas de servidores que ficaram fora de serviço de forma inesperada; implantações em pausa, tráfego redistribuído e reinício dos servidores afetados.
- USA Today (12 nov. 2026), cobertura ao vivo da queda: os relatos de usuários no Downdetector sobre o Outlook atingiram um pico de cerca de 130.000 por volta das 13h10 ET, e os do Microsoft 365 rondaram os 46.000–47.000.
- Microsoft 365 Status (12 nov. 2026): incidências EX1550543 (caixas do Exchange Online) e MO1550821 (serviços do Microsoft 365), no centro de administração do Microsoft 365.
- Ilustração: The Buyer's Pulse.