
Microsoft 365 se cae en todo el mundo: el correo de Outlook, Teams y Copilot, fuera de servicio
Microsoft 365 sufre este jueves una caída global. Los buzones de Exchange Online quedaron inaccesibles por varios métodos de conexión, y la incidencia principal de Microsoft (MO1550821) alcanza también a Teams, SharePoint Online, Microsoft 365 Copilot y Defender XDR; la del correo es la EX1550543 en el centro de administración.
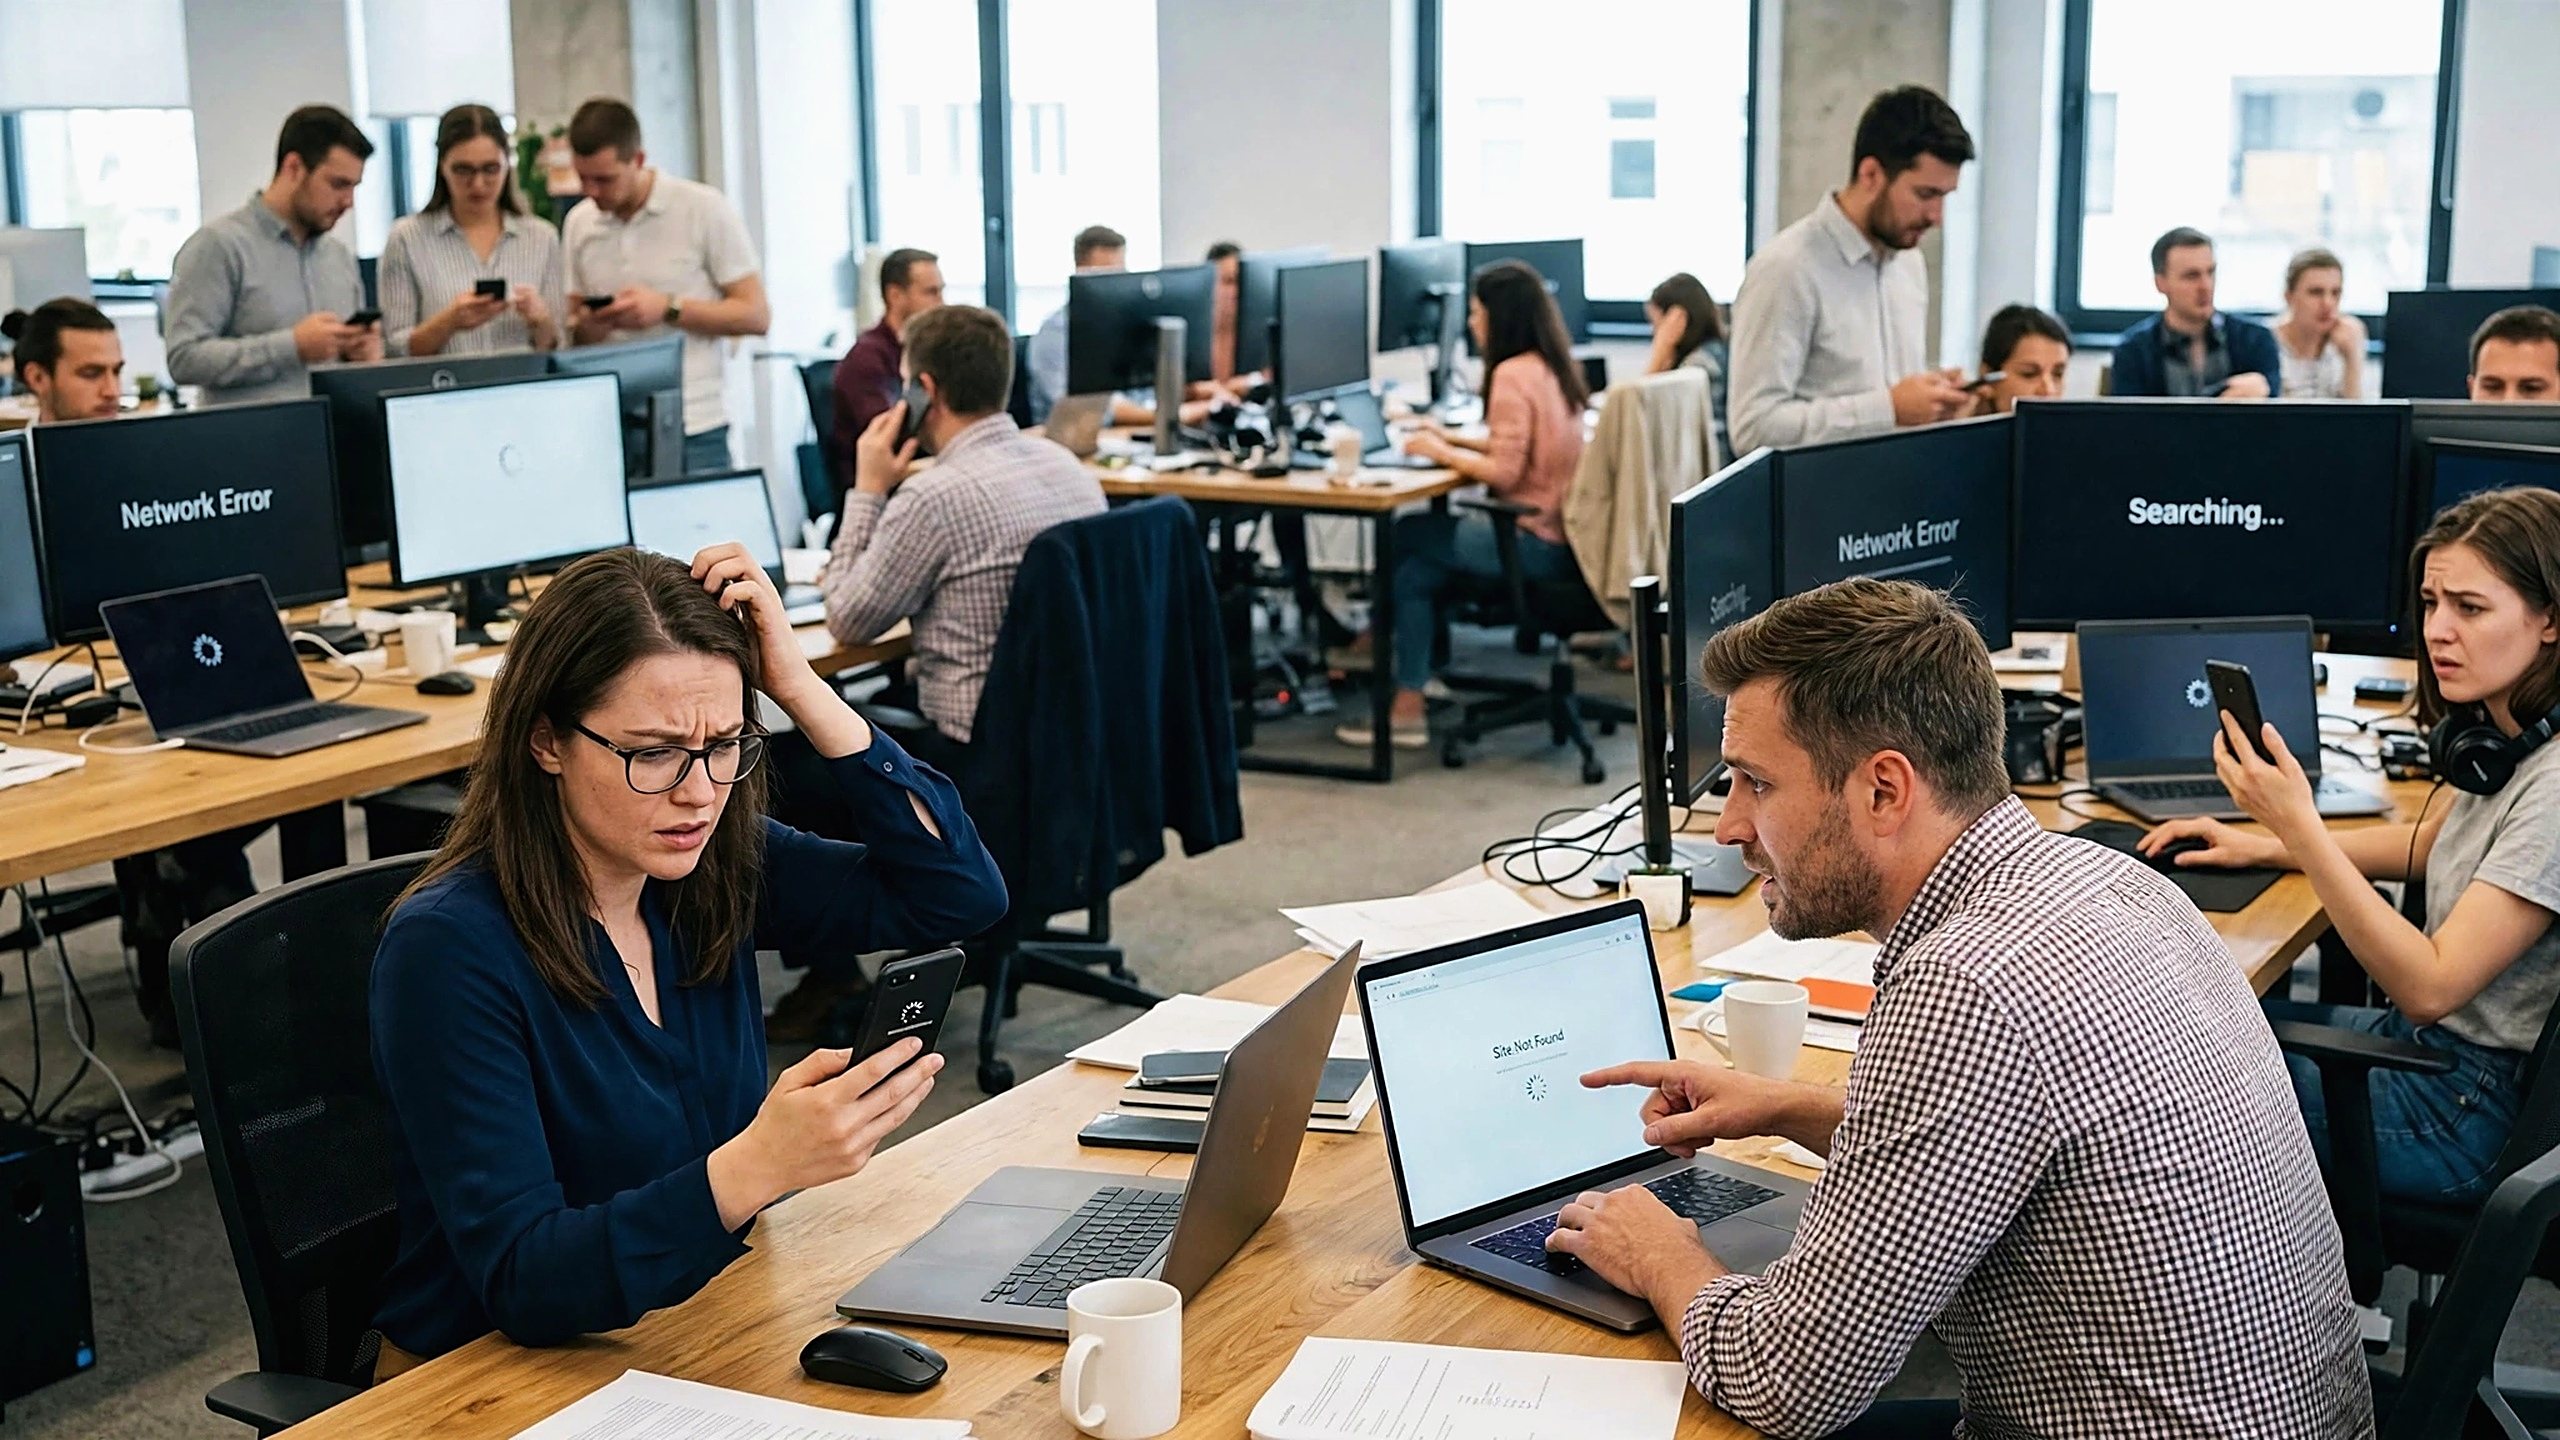
Ilustración: The Buyer's Pulse.
Empezó en las Américas y Microsoft confirmó después que puede afectar a usuarios de cualquier región. En Downdetector, los reportes de usuarios sobre Outlook tocaron un pico de unos 130.000 hacia la 1:10 p. m. ET, y los de Microsoft 365 rondaron los 46.000–47.000.
La causa, según la propia Microsoft —que corrigió su primera explicación—, no fue un aumento de tráfico: una cantidad de servidores quedó fuera de servicio de forma inesperada y saturó la infraestructura restante. La empresa está probando un cambio de configuración ligado a los servidores que fallan sus chequeos automáticos de salud, reinicia los afectados, mantiene todos los despliegues en pausa y redistribuye el tráfico.
Al cierre de esta edición no hay hora estimada de restablecimiento y la caída sigue abierta. Es la segunda falla del día: Teams ya sufrió otra por la mañana, ya resuelta.
Cómo se desarrolló la caída
Según Microsoft, la incidencia de Microsoft 365 comenzó a la 1:26 p. m. ET, aunque sus ingenieros ya investigaban desde antes los reportes de problemas de conexión con los buzones de Exchange Online en las Américas. El primer aviso cubría el servicio de correo; la incidencia mayor, MO1550821, confirmó después que los clientes podían quedarse sin conexión con Exchange Online, Microsoft Teams, SharePoint Online, Microsoft 365 Copilot y Microsoft Defender XDR.
La explicación fue cambiando con la tarde. Microsoft señaló primero una carga elevada en parte de su infraestructura en varias regiones. Después se corrigió a sí misma en una actualización en X: la carga elevada no respondía a un aumento del tráfico, sino a que una cantidad de servidores había quedado fuera de servicio de forma inesperada, forzando la infraestructura restante, y la empresa trabajaba para devolverlos al servicio de forma segura. Dicho de otro modo: primero desapareció capacidad, y la demanda que quedaba cayó sobre menos máquinas.
La mitigación siguió ese diagnóstico. Microsoft pausó todos los despliegues, redistribuyó el tráfico de conexión por su infraestructura mundial, apartó más tráfico de los sistemas afectados y empezó a reiniciar los servidores caídos para recuperar capacidad. Y reconoció que, aunque los primeros reportes llegaron de las Américas, el problema podía afectar a la conectividad de Microsoft 365 de usuarios de cualquier región.
Para quienes intentaban seguir trabajando, la falla era fácil de describir: buzones que no abrían por ninguna de las puertas habituales. El aviso de correo de Microsoft cubre el acceso por varios métodos de conexión, y por eso cambiar entre la aplicación web, el cliente de escritorio y el teléfono no servía de nada: el problema estaba detrás de todos ellos, en el propio servicio, no en una aplicación concreta.
La curva pública de la caída la da Downdetector, que recoge los reportes que envían los propios usuarios. Las quejas se dispararon el jueves por la tarde en Outlook, Microsoft 365, Teams, Copilot, Azure, OneDrive y la Microsoft Store. Los reportes de Outlook tocaron un pico de casi 130.000 hacia la 1:10 p. m. ET, y los de Microsoft 365 superaron los 47.000 poco después; Teams llegó a unos 4.600 reportes y Copilot a unos 6.000. A las 3:20 p. m. ET, unas 69.000 personas seguían reportando problemas con Outlook y unas 31.000 más con Microsoft 365. Esas cifras miden cuánta gente envió un reporte, no cuántos usuarios resultaron afectados: Microsoft no ha dado una cifra de clientes afectados.
La segunda falla del día
La caída de la tarde no fue la primera. Horas antes, el mismo jueves, otra incidencia separada de Teams —registrada como TM1550488— duró de 9:45 a 10:53 a. m. ET y afectó a usuarios de Norteamérica y Sudamérica con demoras y fallos al enviar mensajes, errores al crear o actualizar conversaciones y problemas para recuperar los mensajes del chat. Microsoft atribuyó esa falla a una contención de recursos dentro de su infraestructura, que elevó la utilización hasta que el servicio no pudo procesar las solicitudes de mensajería con normalidad, y afirma que quedó totalmente resuelta. La empresa no ha dicho si ambas incidencias están relacionadas.
La curva, hora a hora
Detrás del pico redondeado hay una cifra exacta: según la cobertura en vivo de USA Today, Downdetector registró exactamente 128.874 reportes de Outlook a la 1:09 p. m. ET. A partir de ahí la curva bajó por etapas, y son las etapas —más que el pico— las que cuentan la historia. A la 1:50 p. m. ET, los reportes de Outlook habían caído a 92.914 y los de Microsoft 365 a unos 37.000: una mejora clara, pero todavía un incidente masivo, menos de una hora después del peor momento.
Después la bajada se frenó: los reportes se instalaron en una meseta relativa entre las 3:30 y las 4 p. m. ET, con algo más de 58.000 reportes de Outlook todavía entrando, y Microsoft 365, un escalón más abajo, unos 19.000 reportes hacia las 3:55 p. m. Las últimas lecturas del directo de USA Today, poco antes de las 5 p. m. ET, situaban Outlook en unos 49.000 reportes y Microsoft 365 en unos 18.800.
Para un gerente de operaciones, esa forma —caída parcial rápida, meseta y descenso lento— es la cronología práctica del incidente: la recuperación era real, pero desigual, y decenas de miles de usuarios seguían reportando horas después del pico. Una curva que baja no es un servicio restablecido: es evidencia sobre la dirección, no la hora de cerrar la emergencia.
Cómo trabajó Microsoft la solución
La mitigación también tiene su reloj. A la 1:07 p. m. ET, Microsoft confirmó en una publicación en X, recogida por USA Today, que el problema podía afectar a la conectividad de Microsoft 365 de usuarios de cualquier región. A la 1:48 p. m. añadió que había empezado a redistribuir el tráfico de conexión por su infraestructura mundial para equilibrar la carga.
En otra actualización reproducida por USA Today, Microsoft lo dijo sin rodeos: estaba siguiendo agresivamente todas las vías para reducir el impacto, había pausado todos los despliegues, estaba apartando más tráfico de la infraestructura afectada y reiniciaba los servidores para devolverlos al servicio.
El avance más claro llegó hacia las 4 p. m. ET. Microsoft afirmó que había validado un método alternativo de comprobación de salud del servicio, que permitió que un subconjunto de los servidores afectados volviera al servicio con éxito, y que ahora aplicaba ese cambio de forma más amplia, además de preparar sistemas de recuperación automática para detectar y reiniciar los servidores que no respondieran. Por esas horas, la compañía dijo que algunos servidores ya habían sido devueltos al servicio y que trabajaba para aplicar la corrección a mayor escala.
A las 4:40 p. m. ET el trabajo seguía siendo de validación, no de cierre: Microsoft dijo que reiniciaba y validaba activamente los servidores afectados para devolverlos al servicio de forma segura, explorando además cómo acelerar el proceso. Incluso entonces, su página de estado seguía mostrando varios servicios —Outlook, Teams, SharePoint, Copilot y Defender— con interrupciones.
Lo que Microsoft no ha dicho
Al cierre de esta edición quedan tres preguntas abiertas. Por qué una cantidad de servidores quedó fuera de servicio al mismo tiempo aún no tiene una respuesta publicada: la empresa corrigió primero lo que la falla no era —un aumento de tráfico— antes de explicar lo que era. Tampoco se ha revelado cuántos clientes resultaron afectados. Y en ningún momento se dio una hora de restablecimiento, de modo que las empresas que esperaban el servicio no tuvieron un reloj oficial con el que planificar, solo la secuencia de actualizaciones.
El silencio tuvo además un segundo canal: USA Today señala que Microsoft no respondió de inmediato a su petición de comentarios adicionales, y BleepingComputer cuenta que contactó a la compañía con preguntas y que actualizaría su nota si recibía respuesta. Más allá de las publicaciones de estado, no hubo versión más completa.
Qué significa para las empresas que operan sobre Microsoft 365
Vuelva a leer la lista de servicios afectados y lo que hay es, en la práctica, el sistema operativo de la empresa: el buzón de correo, la capa de reuniones y chat, el almacén de archivos, el asistente de IA y —con Defender XDR en la lista— parte de la propia consola de seguridad. Cuando todo eso vive en un solo proveedor, una falla de infraestructura deja de ser un ticket de TI y se convierte en una pausa de toda la compañía, a mitad de la jornada laboral y en todas las regiones a la vez. Que la herramienta de detección del equipo de seguridad aparezca en la lista de afectados, justo la tarde en que más se la necesita, es el detalle que los gerentes de riesgo van a subrayar.
El detalle de la incidencia, mientras tanto, vive donde la mayoría de los empleados no puede verlo: los avisos completos están en el centro de administración de Microsoft 365, bajo EX1550543 y MO1550821, visibles para los administradores de cada organización. Para todos los demás hay un buzón que no abre. Un proveedor que pausa todos sus propios despliegues le está diciendo a sus clientes, en efecto, que la estabilidad va antes que cualquier otro cambio: una prioridad razonable, y también una confirmación de la escala de lo que se rompió.
Esa es la decisión que esta caída pone sobre la mesa de los gerentes de TI: no si Microsoft 365 es la suite correcta —para la mayoría de las empresas esa pregunta ya está resuelta—, sino cuánto de la jornada laboral debería depender de una sola nube sin canal de respaldo para el correo y las reuniones, y qué dice el plan de continuidad cuando la respuesta honesta es «todo». Dos incidencias en un mismo día, sin vínculo declarado entre ellas y sin una causa raíz completa todavía, es exactamente el tipo de evidencia que pertenece a la próxima conversación de renovación y de SLA.
Un detalle de la actualización de las 4 p. m. amplía el panorama operativo: según USA Today, la página de estado de salud de Microsoft incluía entonces, entre los servicios afectados, Outlook, Teams, SharePoint, Copilot, Defender, To Do y Purview. To Do y Purview no figuraban en la lista principal con la que abre esta nota: el primero es la capa de tareas desde la que muchos equipos organizan su día; el segundo, parte de las herramientas de cumplimiento. La huella de una caída así rara vez se limita a las aplicaciones de las que la gente se queja primero.
La recuperación, cuando llegó, también fue servicio a servicio y no de golpe. Poco antes de las 5 p. m. ET, USA Today informó de que Copilot parecía estar en línea para la gran mayoría de los usuarios, con los reportes de Outlook todavía en unos 49.000. Para el gerente que decide cuándo retirar el plan alternativo, esa es la decisión que importa: cada servicio se juzga por su propia evidencia, porque la suite no vuelve como un solo bloque —y la herramienta de seguridad seguía figurando como interrumpida a esa hora—.
La división de la información tiene además su propio costo de gestión. El País anota que, para el público general, Microsoft remite a su página de estado, mientras el detalle completo queda en el centro de administración. Eso convierte a los administradores de cada empresa en traductores entre el registro del proveedor y la experiencia de los demás: lo que el empleado ve es una página de estado y un buzón que no abre, y la calidad del mensaje interno depende de lo bien que TI narre una cronología que no controla.
Cuando el correo de millones de personas depende de una sola nube, una caída así no es un incidente técnico más: es la jornada laboral de medio mundo quedando en pausa.
Fuentes
- El País (12 nov 2026): Microsoft confirma una caída global de Microsoft 365 — buzones de Exchange Online inaccesibles por varios métodos de conexión y Copilot entre los servicios afectados; la primera explicación de la compañía apuntó a una carga elevada en parte de su infraestructura, sin hora de restablecimiento.
- BleepingComputer (12 nov 2026), «Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide»: el aviso MO1550821 que cubre Exchange Online, Microsoft Teams, SharePoint Online, Microsoft 365 Copilot y Defender XDR; la corrección de Microsoft — la carga elevada no venía de un aumento de tráfico, sino de servidores que quedaron fuera de servicio de forma inesperada; despliegues en pausa, tráfico redistribuido y reinicio de los servidores afectados.
- USA Today (12 nov 2026), cobertura en vivo de la caída: los reportes de usuarios en Downdetector sobre Outlook tocaron un pico de unos 130.000 hacia la 1:10 p. m. ET, y los de Microsoft 365 rondaron los 46.000–47.000.
- Microsoft 365 Status (12 nov 2026): incidencias EX1550543 (buzones de Exchange Online) y MO1550821 (servicios de Microsoft 365), en el centro de administración de Microsoft 365.
- Ilustración: The Buyer's Pulse.