
O novo modelo da Google não escreve respostas — pontua-as: o Gemini Decision 1 responde a 1.000 perguntas numa única passagem
A Gemini Decisions API da Google DeepMind, lançada a 11 de novembro, funciona com um modelo que não gera texto algum. O Gemini Decision 1 lê uma entrada multimodal — texto, imagens, áudio, vídeo, PDFs — e pontua até 1.000 perguntas de sim/não, escolha múltipla e rubrica contra ela numa única passagem, devolvendo probabilidades com pontuações de confiança em 150 a 250 milissegundos, a $0,10 por milhão de tokens de entrada e zero pela saída.
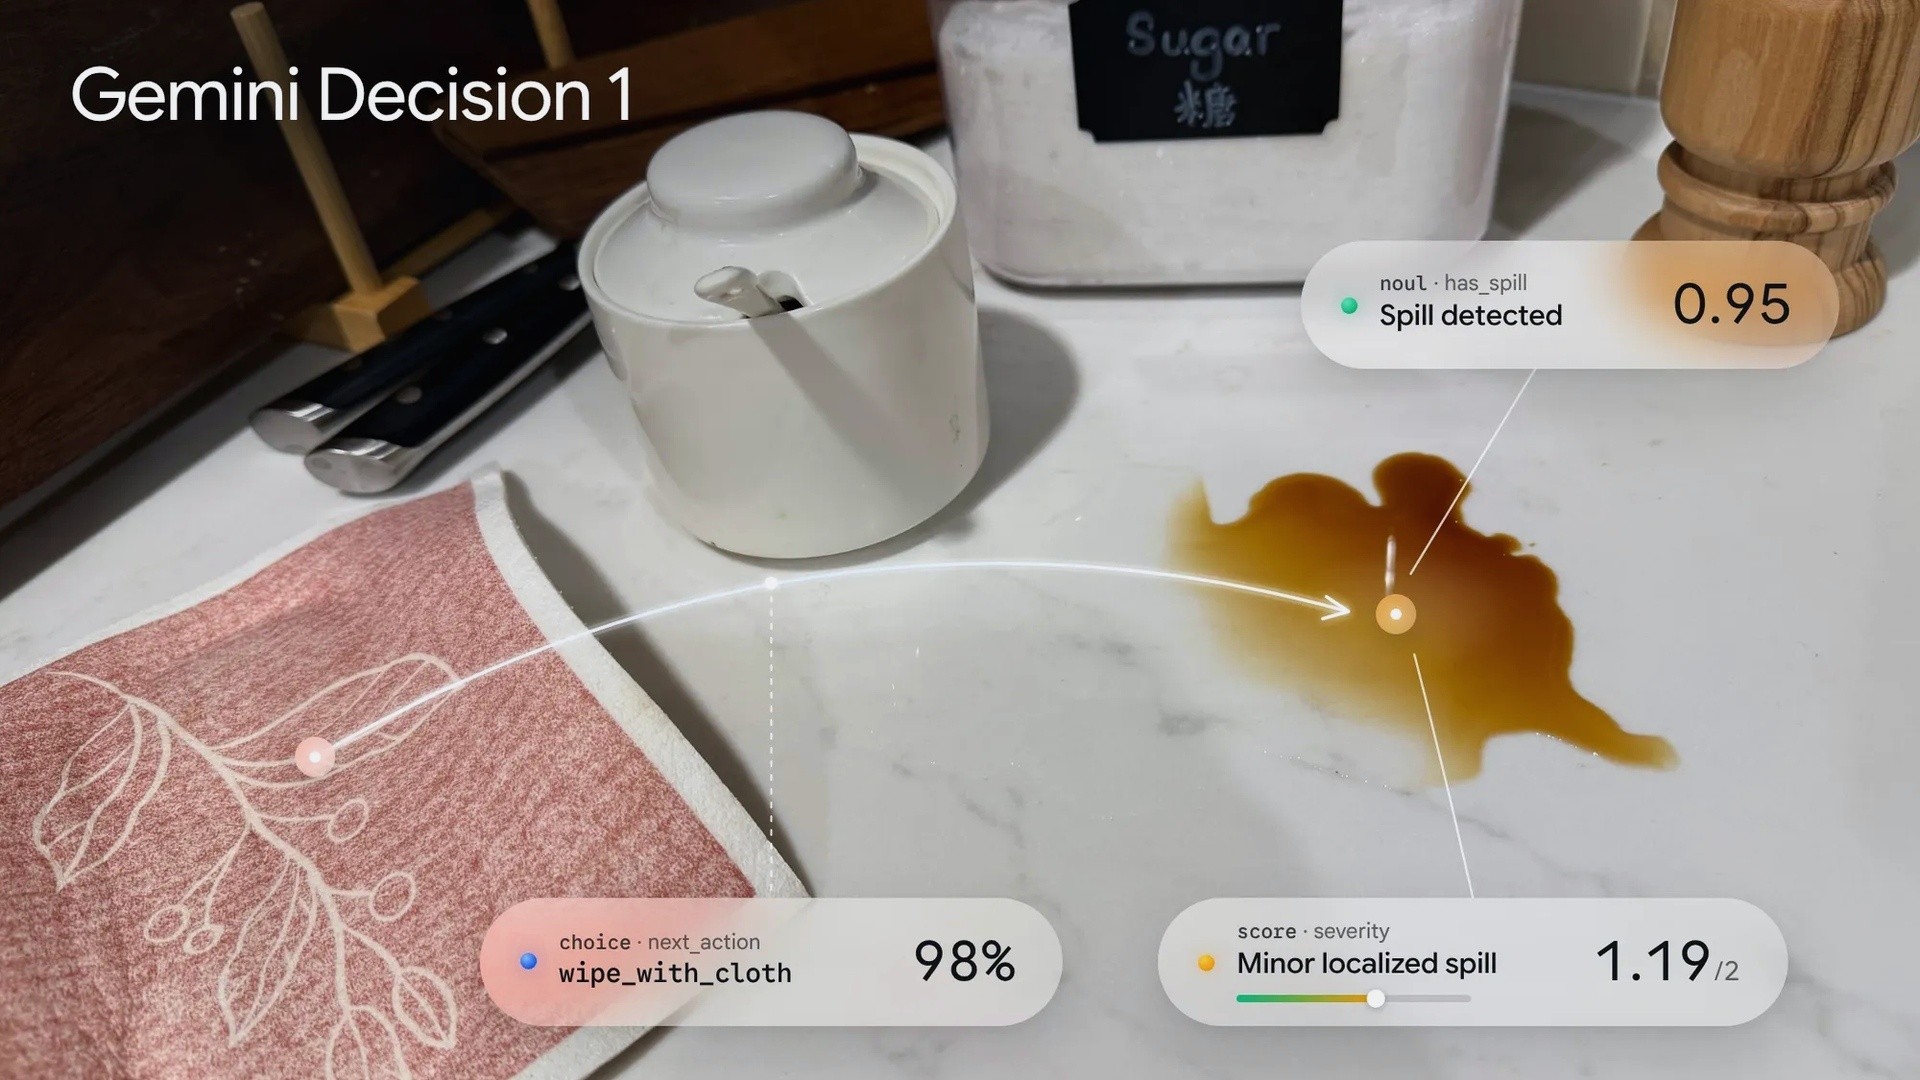
Ilustração: Google DeepMind (blogue oficial) — a imagem de lançamento publicada com o anúncio de 11 de novembro da Gemini Decisions API. O Decision 1 é um modelo de software; a fotografia que pontua é o exemplo desenvolvido pela própria Google.
Um modelo que se recusa a escrever
Todos os modelos de fronteira dos últimos três anos competiram no mesmo eixo: gerar melhor texto. A 11 de novembro, a Google DeepMind lançou um modelo que não gera nenhum. A Gemini Decisions API, anunciada no blogue oficial da Google pela gestora de produto Min Choi e pelo cientista principal Felix Yu, funciona com um modelo novo chamado Gemini Decision 1 (gemini-decision-1): um sistema construído para fazer uma única coisa — olhar uma vez para uma entrada multimodal e pontuar as respostas a até 1.000 perguntas fechadas sobre ela, numa única passagem para a frente.
As perguntas são do tipo que o software faz milhares de vezes por dia e hoje paga a um modelo conversacional completo para responder em prosa: há um derrame nesta foto? Qual destes 200 emojis encaixa nesta mensagem? Esta consulta vai para o modelo rápido ou para o profundo? Esta chamada de ferramenta viola a política? O Gemini Decision 1 não devolve frases: devolve probabilidades, uma para cada resposta permitida, cada uma com uma pontuação de confiança entre 0 e 1, em 150 a 250 milissegundos de latência total.
Três tipos de pergunta, uma única passagem
O vocabulário da API é deliberadamente pequeno. Uma pergunta noul verifica se uma condição de sim/não se cumpre, com descrições opcionais de como são o «verdadeiro» e o «falso». Uma pergunta choice escolhe entre 2 e 255 candidatas e devolve a vencedora com probabilidades normalizadas para cada opção. Uma pergunta score classifica a entrada contra uma rubrica ordenada que começa em 0, devolvendo uma pontuação contínua ponderada e probabilidades por nível. Os três tipos podem misturar-se num único pedido contra a mesma entrada, e a entrada partilhada é faturada uma única vez, independentemente de quantas perguntas viajem sobre ela: cada pergunta acrescenta apenas os tokens da sua própria instrução e dos seus critérios.
O exemplo desenvolvido pela própria Google é a fotografia que abre este artigo: a bancada de uma copa, uma nota de texto («verificação da bancada antes da reunião com o cliente das 9») e três perguntas. O modelo encontra o derrame de café (probabilidade 0,95), escolhe wipe_with_cloth — limpar com um pano — como ação seguinte com 98% de confiança, e classifica a gravidade com 1,19 numa rubrica de 0 a 2. É uma demonstração deliberadamente quotidiana, e é aí que está o ponto: a carga de trabalho visada não é a conversa, mas o julgamento — os milhões de pequenos vereditos delimitados que os sistemas de agentes, os filtros de segurança e as camadas de encaminhamento emitem a cada segundo.
Porque pontuar é mais barato do que escrever
A economia deriva da arquitetura. Um modelo generativo que responde a uma pergunta de classificação tem de descodificar a resposta token a token, e a indústria tem pago preços de tokens de saída — mais a latência da geração — por aquilo que muitas vezes é uma única palavra de conteúdo. Um modelo de decisões salta a descodificação por completo: uma passagem para a frente sobre a entrada, uma cabeça de pontuação por pergunta. A Google afirma que o cálculo mediano do modelo se mantém entre 50 e 100 milissegundos e permanece quase plano quando um pedido cresce de 1 para 100 perguntas com contextos até 16K tokens, porque a parte cara — ler a entrada — acontece uma única vez.
Daí o cartão de preços: $0,10 por milhão de tokens de entrada e zero pela saída, sem encargos separados por transcrição de áudio nem por OCR, e com um nível sem custo no Google AI Studio para prototipar. A Google sustenta que a configuração é quase cinco vezes mais barata do que executar as mesmas avaliações com o Gemini 3.5 Flash-Lite na Interactions API, numa suite de benchmarks partilhada que abrange encaminhamento de agentes, raciocínio, ranking e compreensão multimodal — uma suite na qual, diz a empresa, o Decision 1 lidera com o menor erro de calibração. São os números do fabricante, publicados com o lançamento; a réplica independente ainda não apareceu. Mas a direção da afirmação pode ser verificada por qualquer programador com uma chave de API, o que é mais do que se pode dizer da maioria das tabelas de benchmarks.
Já está a correr dentro da Google
A evidência mais sólida da Google não é a tabela de benchmarks, mas a lista dos seus próprios produtos já ligados à API. O Gemini Notebook usa-a como encaminhador em tempo real: classifica a intenção das consultas que chegam em milissegundos e envia as perguntas quotidianas para níveis mais leves — até 40% menos de latência, diz a empresa — reservando os modelos de raciocínio profundo para as tarefas difíceis. O Stitch, a ferramenta de design da Google, usa-a numa experiência de tela rápida que transforma edições por voz ou por toque em wireframes navegáveis em segundos. O CC, um assistente do Google Labs, usa-a para escolher a reação emoji certa de uma paleta de mais de 200 opções. E a Pesquisa usa-a como camada de segurança, examinando o comportamento de ferramentas MCP em busca de padrões adversários dentro da margem de latência que uma página de pesquisa permite.
Essa lista desenha o mercado visado com precisão: não os utilizadores finais, mas os planos de controlo de outros sistemas de IA. À medida que as arquiteturas de agentes se multiplicam, o número de microdecisões por pedido do utilizador — encaminhar, classificar, autorizar, ordenar, verificar — cresce mais depressa do que o próprio número de pedidos. A Google está a vender a camada que toma essas decisões a um preço e a uma velocidade que fazem «perguntar ao modelo grande» parecer um desperdício.
A letra pequena
A documentação do lançamento traça limites claros. A Decisions API corre sobre a Gemini Developer API, através do Google AI Studio; o suporte no Vertex AI, da Google Cloud, está prometido mas sem data. Segundo a documentação lida no momento do lançamento, o modelo não admite Batch API, nem cache de contexto, nem chamada de funções nem saída estruturada: é um endpoint de pontuação, não um modelo geral com extras cortados. O próprio endpoint é dedicado (POST /v1beta/decisions) e os SDK oficiais precisam do google-genai 3.2 ou posterior. As integrações com o ecossistema estão a ser lançadas em OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit e OpenCode.
Há também um limite conceptual que vale a pena nomear. Um modelo que só pontua as opções que lhe dão não consegue notar a opção esquecida. Os seus julgamentos são calibrados, diz a Google — as probabilidades significam alguma coisa —, mas são julgamentos dentro de um quadro desenhado pelo programador. A pontuação de confiança é a válvula de segurança: encaminhar os casos incertos para um modelo maior ou para um humano faz com que a honestidade do sistema sobre a sua própria incerteza passe a fazer parte do desenho.
O que entusiasma
- A forma certa para o trabalho: encaminhar, classificar e verificar políticas nunca precisou de prosa; um pontuador é mais rápido, mais barato e mais fácil de ligar ao código do que um chatbot que emite JSON.
- Incerteza honesta: cada resposta traz uma pontuação de confiança calibrada, para que os casos ambíguos possam ser escalados por desenho e não por falha.
- A entrada fatura-se uma vez: 1.000 perguntas sobre um documento, um vídeo ou uma gravação custam uma única leitura da entrada: uma forma de preço genuinamente nova para as cargas de avaliação.
O que vigiar
- Benchmarks do fabricante: as afirmações de «lidera a suite, ~5× mais barato» são da Google, medidas contra o seu próprio Flash-Lite; a réplica de terceiros está pendente.
- Um instrumento estreito: sem Batch API, sem cache e sem chamada de funções no lançamento, e com o suporte do Vertex AI sem data: a adoção empresarial espera pelo roteiro da plataforma.
- O problema do quadro: o modelo pontua as opções que recebe; um conjunto de opções mal desenhado recebe respostas rápidas, confiantes e erradas.
Uma categoria nova, com preço de serviço básico
Com distância, o lançamento marca uma mudança estrutural no que é vendido como «modelo». A família Gemini abrange agora modelos que raciocinam (Carbon), modelos que respondem à escala da população (Hydrogen) e, com o Decision 1, um modelo que julga: um componente industrial cuja saída não é conteúdo, mas controlo. A Google não está sozinha a ver a camada: na mesma semana surgiram modelos de decisão alojados no ecossistema de código aberto. Mas a Google colocou um preço, um número de latência e o seu próprio tráfego de produção atrás da ideia.
O teste chega depressa, porque a afirmação é falsificável numa tarde: qualquer equipa que hoje classifica através de um modelo conversacional pode reencaminhar uma amostra pela Decisions API e comparar custo, latência e precisão sobre os seus próprios dados. Se os números se confirmarem, uma fatia significativa do que a indústria compra hoje como «geração» sempre foi apenas julgamento com um disfarce mais caro — e 11 de novembro é o dia em que o maior vendedor de modelos o disse em voz alta, e pôs na alternativa o preço de dez cêntimos.
𝐋𝐄𝐈𝐀 𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐔𝐈𝐓𝐀 𝐄𝐌 thebuyerspulse.com/pt/
A folha de especificações
Gemini Decision 1 (Google DeepMind)
| Campo | Detalhe |
| ID do modelo | gemini-decision-1 |
| Anunciado | 11 de novembro de 2026 — blogue oficial da Google (Min Choi, Felix Yu) |
| Acesso | Gemini API no Google AI Studio; nível gratuito de prototipagem |
| Perguntas | Até 1.000 por pedido — noul (sim/não), choice (de 2 a 255 opções), score (rubrica ordenada) |
| Entrada | Uma entrada multimodal partilhada até 256K tokens: texto, imagens, áudio, vídeo, PDFs |
| Latência | 150–250 ms no total; cálculo mediano do modelo de 50–100 ms (Google) |
| Preço | $0,10 por milhão de tokens de entrada; $0 de saída; a entrada fatura-se uma vez por pedido |
| Limites no lançamento | Sem Batch API, cache de contexto, chamada de funções nem saída estruturada (documentação); suporte do Vertex AI por vir |
Fontes
- Google, blogue oficial (Min Choi e Felix Yu, Google DeepMind, 11 de novembro de 2026): «Gemini Decisions API: Fast multimodal decisions» — o modelo, os três tipos de pergunta, a entrada de 256K tokens, a latência e os preços, as afirmações de benchmarks e calibração, os usos internos (Gemini Notebook, Stitch, CC, Pesquisa) e as integrações com o ecossistema.
- Documentação da Gemini API e cobertura do lançamento lidas entre 11 e 14 de novembro de 2026 (GeekByte, MLQ, rastreadores de agentes de IA): o endpoint /v1beta/decisions, o requisito do SDK google-genai 3.2 e os limites de lançamento — sem Batch API, cache de contexto, chamada de funções nem saída estruturada; suporte do Vertex AI prometido, sem data.
- Ilustração: Google DeepMind (blogue oficial) — a imagem de lançamento do Gemini Decision 1 (decisions-hero-hud) publicada com o anúncio de 11 de novembro.