
El nuevo modelo de Google no escribe respuestas — las puntúa: Gemini Decision 1 responde 1.000 preguntas en una sola pasada
La Gemini Decisions API de Google DeepMind, lanzada el 11 de noviembre, funciona con un modelo que no genera texto alguno. Gemini Decision 1 lee una entrada multimodal — texto, imágenes, audio, video, PDF — y puntúa hasta 1.000 preguntas de sí/no, opción múltiple y rúbrica contra ella en una sola pasada, devolviendo probabilidades con puntuaciones de confianza en 150 a 250 milisegundos, a $0,10 por millón de tokens de entrada y cero por la salida.
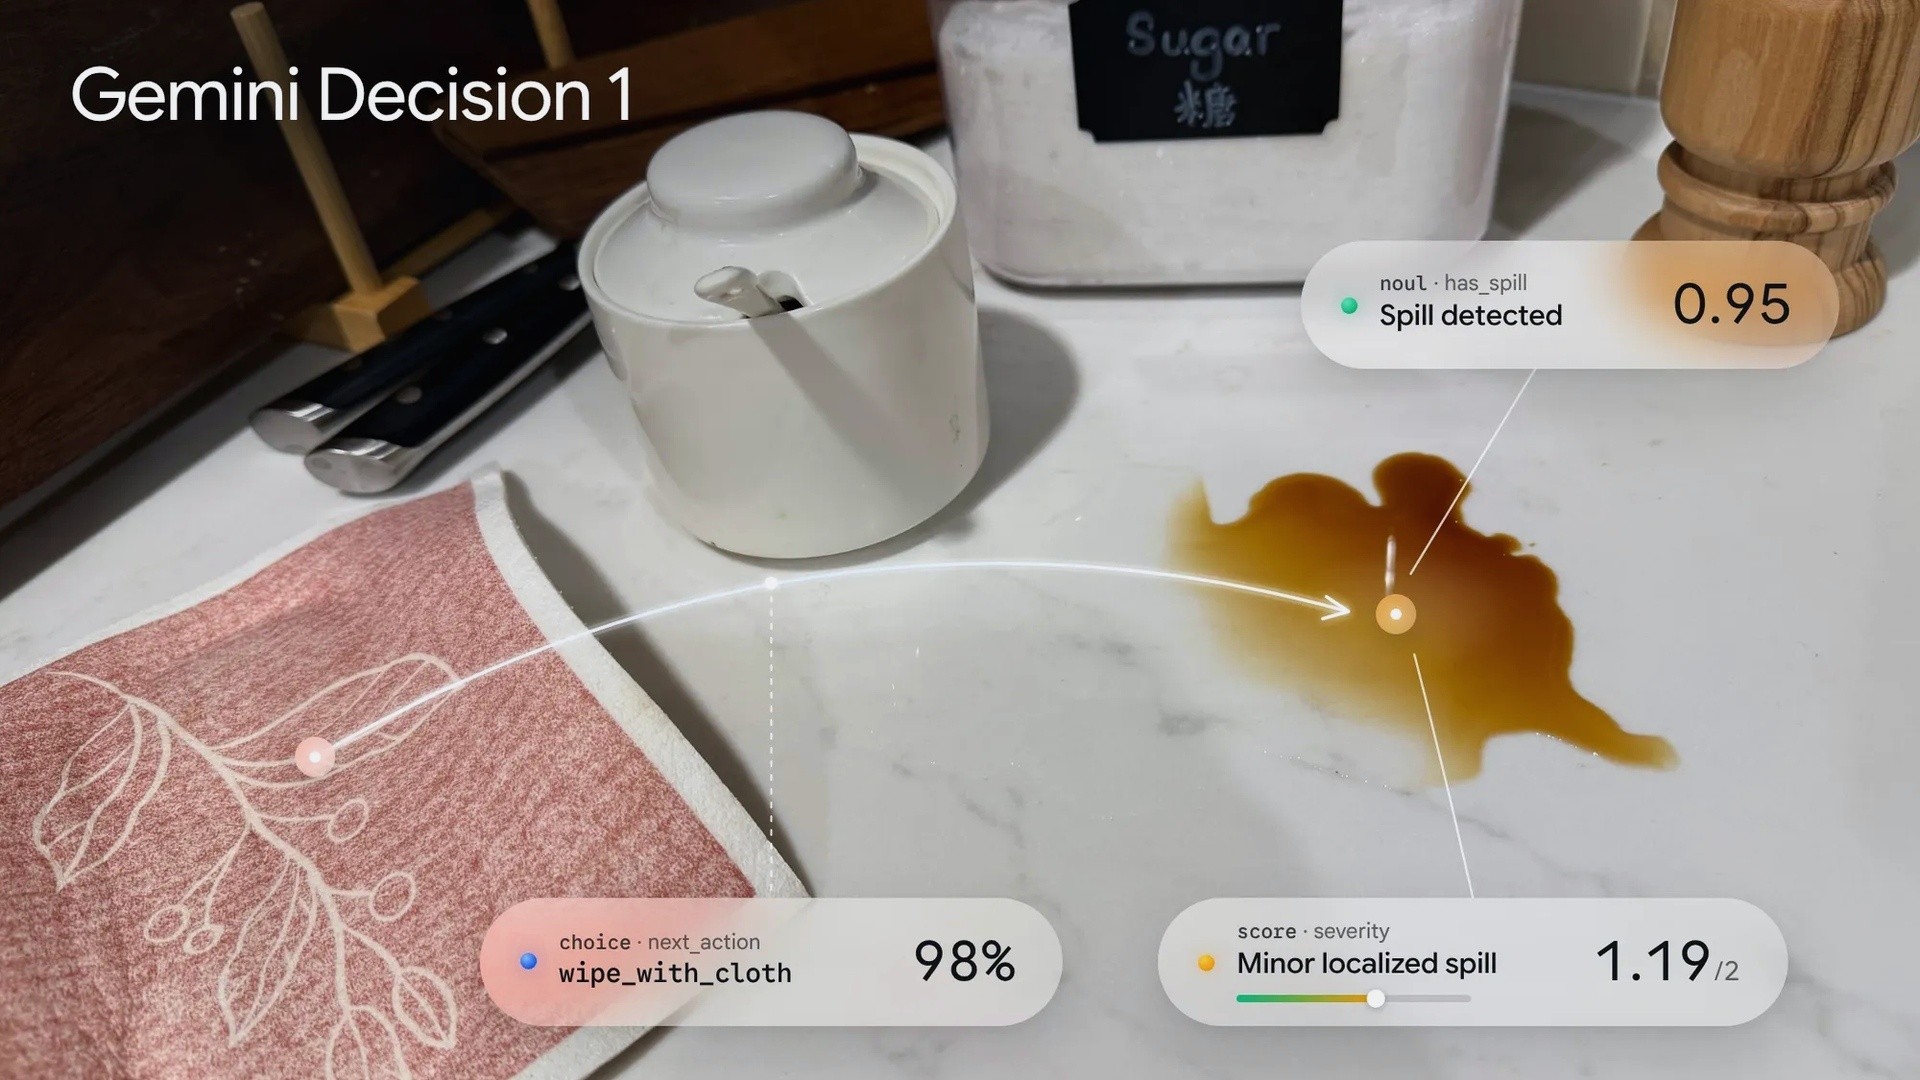
Ilustración: Google DeepMind (blog oficial) — la imagen de lanzamiento publicada con el anuncio del 11 de noviembre de la Gemini Decisions API. Decision 1 es un modelo de software; la fotografía que puntúa es el ejemplo desarrollado por la propia Google.
Un modelo que se niega a escribir
Todos los modelos de frontera de los últimos tres años han competido en el mismo eje: generar mejor texto. El 11 de noviembre, Google DeepMind lanzó un modelo que no genera ninguno. La Gemini Decisions API, anunciada en el blog oficial de Google por la gerenta de producto Min Choi y el científico principal Felix Yu, funciona con un modelo nuevo llamado Gemini Decision 1 (gemini-decision-1): un sistema construido para hacer una sola cosa — mirar una entrada multimodal una vez y puntuar las respuestas a hasta 1.000 preguntas cerradas sobre ella, en una sola pasada hacia adelante.
Las preguntas son del tipo que el software formula miles de veces al día y hoy paga a un modelo conversacional completo por responder en prosa: ¿hay un derrame en esta foto?, ¿cuál de estos 200 emojis encaja con este mensaje?, ¿esta consulta va al modelo rápido o al profundo?, ¿esta llamada a una herramienta viola la política? Gemini Decision 1 no devuelve frases: devuelve probabilidades, una por cada respuesta permitida, cada una con una puntuación de confianza entre 0 y 1, en 150 a 250 milisegundos de latencia total.
Tres tipos de pregunta, una sola pasada
El vocabulario de la API es deliberadamente pequeño. Una pregunta noul consulta si se cumple una condición de sí/no, con descripciones opcionales de cómo se ven el «verdadero» y el «falso». Una pregunta choice elige entre 2 y 255 candidatas y devuelve la ganadora con probabilidades normalizadas para cada opción. Una pregunta score califica la entrada contra una rúbrica ordenada que empieza en 0, y devuelve una puntuación continua ponderada y probabilidades por nivel. Los tres tipos pueden mezclarse en una sola solicitud contra la misma entrada, y la entrada compartida se factura una sola vez, sin importar cuántas preguntas viajen sobre ella: cada pregunta añade solo los tokens de su propia instrucción y sus criterios.
El ejemplo que desarrolla la propia Google es la fotografía que encabeza este artículo: la encimera de una sala de descanso, una nota de texto («revisión de la encimera antes de la reunión con el cliente de las 9») y tres preguntas. El modelo encuentra el derrame de café (probabilidad 0,95), elige wipe_with_cloth — limpiar con un paño — como acción siguiente con 98% de confianza, y califica la gravedad con 1,19 en una rúbrica de 0 a 2. Es una demostración deliberadamente cotidiana, y ahí está el punto: la carga de trabajo a la que se apunta no es la conversación, sino el juicio — los millones de pequeños veredictos acotados que los sistemas de agentes, los filtros de seguridad y las capas de enrutamiento emiten cada segundo.
Por qué puntuar es más barato que escribir
La economía se deriva de la arquitectura. Un modelo generativo que responde una pregunta de clasificación debe decodificar la respuesta token a token, y la industria ha estado pagando precios de tokens de salida — más la latencia de la generación — por lo que a menudo es una sola palabra de contenido. Un modelo de decisiones se salta la decodificación por completo: una pasada hacia adelante sobre la entrada, un cabezal de puntuación por pregunta. Google afirma que el cómputo mediano del modelo se mantiene entre 50 y 100 milisegundos y permanece casi plano cuando una solicitud crece de 1 a 100 preguntas con contextos de hasta 16K tokens, porque la parte cara — leer la entrada — ocurre una sola vez.
De ahí la tarjeta de precios: $0,10 por millón de tokens de entrada y cero por la salida, sin cargos separados por transcripción de audio ni por OCR, y con un nivel sin costo en Google AI Studio para prototipar. Google sostiene que la configuración es casi cinco veces más barata que ejecutar las mismas evaluaciones con Gemini 3.5 Flash-Lite en la Interactions API, en una suite de benchmarks compartida que abarca enrutamiento de agentes, razonamiento, ranking y comprensión multimodal — una suite en la que, dice la empresa, Decision 1 lidera con el menor error de calibración. Son las cifras del fabricante, publicadas con el lanzamiento; la réplica independiente todavía no aparece. Pero la dirección de la afirmación puede comprobarla cualquier desarrollador con una clave de API, lo que es más de lo que puede decirse de la mayoría de las tablas de benchmarks.
Ya está corriendo dentro de Google
La evidencia más sólida de Google no es la tabla de benchmarks, sino la lista de sus propios productos ya conectados a la API. Gemini Notebook la usa como enrutador en tiempo real: clasifica la intención de las consultas entrantes en milisegundos y envía las preguntas cotidianas a niveles más ligeros — hasta 40% menos de latencia, dice la empresa — reservando los modelos de razonamiento profundo para las tareas difíciles. Stitch, la herramienta de diseño de Google, la usa en un experimento de lienzo rápido que convierte ediciones por voz o por tacto en wireframes navegables en segundos. CC, un asistente de Google Labs, la usa para elegir la reacción emoji correcta de una paleta de más de 200 opciones. Y Search la usa como capa de seguridad, examinando el comportamiento de herramientas MCP en busca de patrones adversarios dentro del margen de latencia que una página de búsqueda permite.
Esa lista dibuja el mercado buscado con precisión: no los usuarios finales, sino los planos de control de otros sistemas de IA. A medida que las arquitecturas de agentes se multiplican, el número de microdecisiones por solicitud de usuario — enrutar, calificar, autorizar, ordenar, verificar — crece más rápido que el número de solicitudes mismas. Google está vendiendo la capa que toma esas decisiones a un precio y una velocidad que hacen que «preguntarle al modelo grande» parezca un desperdicio.
La letra pequeña
La documentación del lanzamiento traza límites claros. La Decisions API corre sobre la Gemini Developer API, a través de Google AI Studio; el soporte en Vertex AI, de Google Cloud, está prometido pero sin fecha. Según la documentación leída al momento del lanzamiento, el modelo no admite Batch API, ni caché de contexto, ni llamada a funciones ni salida estructurada: es un endpoint de puntuación, no un modelo general con extras recortados. El endpoint mismo es dedicado (POST /v1beta/decisions) y los SDK oficiales necesitan google-genai 3.2 o posterior. Las integraciones con el ecosistema están desplegándose en OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit y OpenCode.
Hay también un límite conceptual que vale la pena nombrar. Un modelo que solo puntúa las opciones que le das no puede notar la opción que olvidaste. Sus juicios están calibrados, dice Google — las probabilidades significan algo —, pero son juicios dentro de un marco que dibujó el desarrollador. La puntuación de confianza es la válvula de seguridad: enrutar los casos inciertos a un modelo mayor o a un humano hace que la honestidad del sistema sobre su propia incertidumbre pase a ser parte del diseño.
Lo que entusiasma
- La forma correcta para el trabajo: enrutar, calificar y verificar políticas nunca necesitó prosa; un puntuador es más rápido, más barato y más fácil de conectar al código que un chatbot que emite JSON.
- Incertidumbre honesta: cada respuesta lleva una puntuación de confianza calibrada, así que los casos ambiguos pueden escalarse por diseño y no por falla.
- La entrada se factura una vez: 1.000 preguntas sobre un documento, un video o una grabación cuestan una sola lectura de la entrada: una forma de precio genuinamente nueva para las cargas de evaluación.
Lo que hay que vigilar
- Benchmarks del fabricante: las afirmaciones de «lidera la suite, ~5× más barato» son de Google, medidas contra su propio Flash-Lite; la réplica de terceros está pendiente.
- Un instrumento estrecho: sin Batch API, sin caché y sin llamada a funciones en el lanzamiento, y con el soporte de Vertex AI sin fecha: la adopción empresarial espera la hoja de ruta de la plataforma.
- El problema del marco: el modelo puntúa las opciones que recibe; un conjunto de opciones mal dibujado recibe respuestas rápidas, confiadas y equivocadas.
Una categoría nueva, con precio de servicio básico
Con distancia, el lanzamiento marca un cambio estructural en qué es lo que se vende como «modelo». La familia Gemini ahora abarca modelos que razonan (Carbon), modelos que responden a escala poblacional (Hydrogen) y, con Decision 1, un modelo que juzga: un componente industrial cuya salida no es contenido, sino control. Google no está solo en ver la capa: la misma semana aparecieron modelos de decisión alojados en el ecosistema de código abierto. Pero Google le ha puesto un precio, una cifra de latencia y su propio tráfico de producción detrás de la idea.
La prueba llega rápido, porque la afirmación es falsable en una tarde: cualquier equipo que hoy clasifica a través de un modelo conversacional puede reenviar una muestra por la Decisions API y comparar costo, latencia y precisión sobre sus propios datos. Si las cifras se sostienen, una porción significativa de lo que la industria compra hoy como «generación» siempre fue solo juicio con un disfraz más caro — y el 11 de noviembre es el día en que el mayor vendedor de modelos lo dijo en voz alta, y le puso a la alternativa el precio de diez centavos.
𝐂𝐎𝐍𝐒𝐈𝐆𝐔𝐄 𝐋𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐈𝐒 𝐄𝐍 thebuyerspulse.com/es/
Ficha técnica
Gemini Decision 1 (Google DeepMind)
| Campo | Detalle |
| ID del modelo | gemini-decision-1 |
| Anunciado | 11 de noviembre de 2026 — blog oficial de Google (Min Choi, Felix Yu) |
| Acceso | Gemini API en Google AI Studio; nivel gratuito de prototipado |
| Preguntas | Hasta 1.000 por solicitud — noul (sí/no), choice (de 2 a 255 opciones), score (rúbrica ordenada) |
| Entrada | Una entrada multimodal compartida de hasta 256K tokens: texto, imágenes, audio, video, PDF |
| Latencia | 150–250 ms en total; cómputo mediano del modelo de 50–100 ms (Google) |
| Precio | $0,10 por millón de tokens de entrada; $0 de salida; la entrada se factura una vez por solicitud |
| Límites al lanzamiento | Sin Batch API, caché de contexto, llamada a funciones ni salida estructurada (documentación); soporte de Vertex AI por venir |
Fuentes
- Google, blog oficial (Min Choi y Felix Yu, Google DeepMind, 11 de noviembre de 2026): «Gemini Decisions API: Fast multimodal decisions» — el modelo, los tres tipos de pregunta, la entrada de 256K tokens, la latencia y los precios, las afirmaciones de benchmarks y calibración, los usos internos (Gemini Notebook, Stitch, CC, Search) y las integraciones con el ecosistema.
- Documentación de la Gemini API y cobertura del lanzamiento leídas entre el 11 y el 14 de noviembre de 2026 (GeekByte, MLQ, rastreadores de agentes de IA): el endpoint /v1beta/decisions, el requisito del SDK google-genai 3.2 y los límites de lanzamiento — sin Batch API, caché de contexto, llamada a funciones ni salida estructurada; soporte de Vertex AI prometido, sin fecha.
- Ilustración: Google DeepMind (blog oficial) — la imagen de lanzamiento de Gemini Decision 1 (decisions-hero-hud) publicada con el anuncio del 11 de noviembre.