Google envía cuatro sistemas de chip de IA en un año: las nuevas TPU cifran datos en uso y duplican el muro de memoria
Google ha dejado de tratar su chip como un componente. El 9 de noviembre, la compañía completó una octava generación construida como una línea de productos: un sistema que mantiene los datos cifrados mientras computa y otro que duplica el muro de memoria dentro del mismo rack, apuntando directo a las cargas de trabajo que los clientes de Nvidia no pueden mover con facilidad.
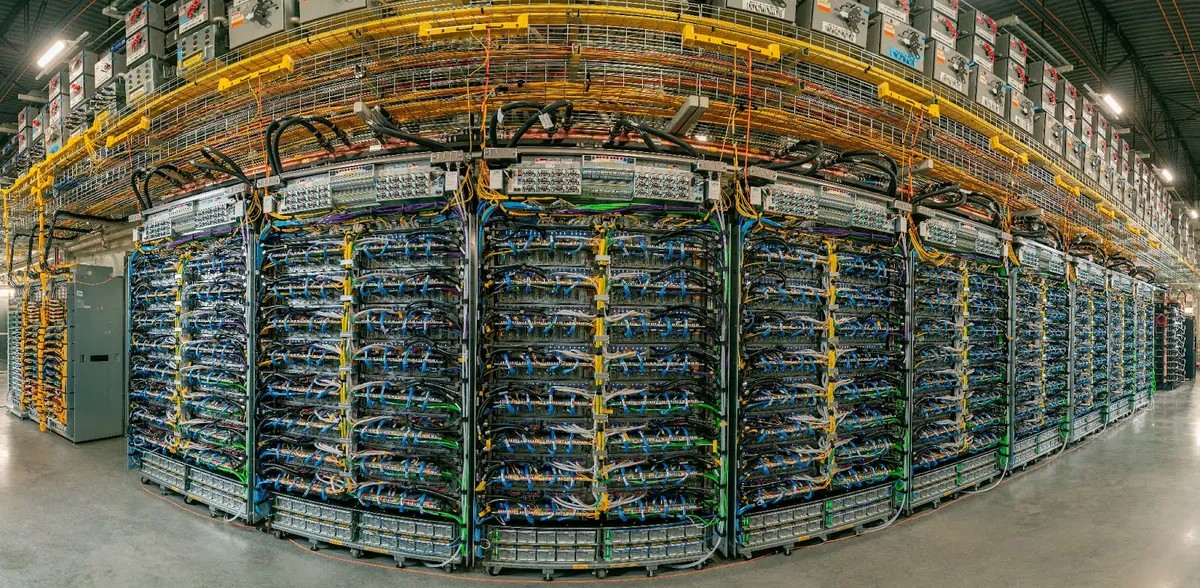
Foto: Google (blog oficial). La fotografía muestra un superpod Ironwood (séptima generación) — la infraestructura TPU actual de Google; todavía no existe ninguna instalación de octava generación para fotografiar.
Cuatro sistemas, un año, sin nuevo silicio necesario
Google ha hecho algo que nunca antes había hecho: enviar cuatro sistemas de chip de IA en un solo año calendario. El lunes 9 de noviembre, la compañía añadió el TPU 8tx y el TPU 8i Max a su línea de octava generación, completando un portafolio que comenzó en abril en Cloud Next con el TPU 8t para entrenamiento y el TPU 8i para razonamiento en tiempo real. Los dos sistemas de abril establecieron la línea base de la generación: hasta 2,7x mejor rendimiento de entrenamiento por parte del 8t y un 80% mejor relación precio-rendimiento de inferencia por parte del 8i, medido frente a la generación anterior. Los dos sistemas de noviembre apuntan a problemas más específicos y urgentes: mantener secretos mientras un modelo los está usando y alimentar agentes que piensan en millones de tokens a la vez.
Nótese lo que Google no anunció: dos chips totalmente nuevos. El 8tx está construido sobre el mismo silicio que el 8t; el 8i Max son dos chips 8i fusionados en un solo paquete. Eso no es un atajo; es la estrategia, y la compañía lo dice en voz alta. Un chip toma años de física y fabricación; un sistema —el empaquetado, la memoria, la red, los hosts y la seguridad que envuelven al silicio— se puede reconstruir en meses. Google diseñó sus TPU como bloques modulares desde hace casi una década precisamente para poder responder a un mercado que se mueve a la velocidad de los agentes, y cuatro sistemas en doce meses son el recibo. El negocio detrás de esto ya no es un proyecto científico: la operación de TPU ahora cuenta con casi 100 clientes, dice Google —laboratorios de IA de frontera, firmas de trading, minoristas y universidades—, y Alphabet reportó que las ventas de sistemas TPU contribuyeron a un trimestre de septiembre en el que los ingresos de Google Cloud se más que duplicaron interanualmente, hasta los 30.710 millones de dólares.
TPU 8tx: la máquina que guarda secretos mientras trabaja
Cada sistema cifrado tiene el mismo agujero. Los datos están protegidos mientras residen en un disco y mientras cruzan una red, pero en el momento en que un computador realmente los procesa, los datos se descifran en la memoria, legibles por cualquier cosa que comparta esa máquina. Para una red hospitalaria, un banco o un ministerio, ese momento es exactamente donde el departamento de cumplimiento dice que no, y es la razón por la cual algunas de las cargas de trabajo de IA más valiosas del planeta —modelos ejecutados contra registros médicos, datos financieros, archivos de ciudadanos— se han mantenido alejadas del hardware más capaz.
El TPU 8tx es la respuesta de Google, y está construido expresamente para empresas reguladas y gobiernos. Sobre el mismo silicio que el 8t de nivel de entrenamiento, emparejado con procesadores host AMD EPYC de quinta generación, traslada la seguridad a la propia capa de hardware: los datos sensibles y los pesos de los modelos se mantienen protegidos y aislados incluso durante su uso activo, cifrados no solo en reposo y en tránsito, sino en el acto de ser procesados. Google combina esto con la red Boardfly de baja latencia del 8i y afirma tener hasta 2x menor latencia que el 8t con una penalización de rendimiento cercana a cero, para que los agentes de múltiples pasos sigan avanzando en lugar de esperar en la capa de seguridad. Y como la misma caja lleva cómputo de nivel de entrenamiento, un equipo puede ajustar finamente un modelo con datos privados, destilarlo en uno más pequeño y entrenar agentes contra él, sin migrar nunca los datos sensibles a un cluster separado, que es donde suelen ocurrir las fugas y los hallazgos de auditoría.
TPU 8i Max: dos chips, un paquete, el doble de muro
El segundo sistema nuevo ataca el otro muro en la infraestructura de IA: la memoria. Cuando docenas de agentes trabajan juntos a través de todo un código de software o horas de video, el cuello de botella ya no es el cómputo bruto, sino la rapidez con la que la máquina puede alimentar de contexto a los chips. La respuesta de Google es desarmantemente física: toma dos chips 8i de baja latencia y combínalos en un solo paquete. El 8i Max ofrece el doble de cómputo, el doble de SRAM y el doble de ancho de banda de memoria de gran ancho de banda (HBM) de un solo 8i, y como cabe el doble de silicio dentro del espacio de rack existente, un data center obtiene significativamente más potencia de cómputo por pie cuadrado y por vatio, las dos monedas de las que realmente carece todo operador.
Los números absolutos, reportados por Network World a partir de la sesión informativa de Google Cloud, esbozan la forma de la máquina: 384 GB de memoria de gran ancho de banda por paquete (alrededor de un tercio más que el 8i), 17,2 TB/s de ancho de banda de memoria y 768 MB de SRAM en el chip. Alrededor del hardware, Google está abriendo el código de la capa de estado del modelo que llama TPU Sync, la cual organiza en niveles las gigantescas cachés de clave-valor de los modelos de contexto largo fuera del chip y afirma reducir su latencia de transferencia —y el tiempo hasta el primer token— en más del 90%. La octava generación, tomada en conjunto, se lee ahora como un menú escrito para la era agéntica: el 8t para entrenamiento de escalado (scale-up), el 8i para razonamiento de baja latencia, el 8tx para cómputo confidencial, y el 8i Max para ventanas de contexto masivas y la mayor densidad de cómputo por rack.
Se abre la puerta: PyTorch, sin reescrituras
El hardware nunca fue el único foso defensivo en los chips de IA; el ecosistema de software lo era, y Google dedicó el mismo anuncio a atacarlo. El mes pasado, la compañía abrió el código de TorchTPU, por lo que el código de PyTorch y los modelos de Hugging Face ahora se ejecutan de forma nativa en las TPU —sin reescrituras de código— junto con backends para los motores de inferencia vLLM y SGLang que el mundo de código abierto realmente utiliza. Un nuevo conjunto de agentes de código abierto se conecta a las herramientas de codificación para automatizar la incorporación y el ajuste de las TPU en lenguaje sencillo, y Google afirma que su stack nativo ostenta marcas de precio-rendimiento de vanguardia en los benchmarks InferenceX y AgentX, que prueban la codificación agéntica realista y el trabajo de contexto largo. El subtexto está dirigido a cada equipo de ingeniería que alguna vez optó por defecto por el titular: el costo de cambio al que le tenías miedo es lo que acabamos de borrar.
La decisión que esto plantea
Despoja el lenguaje de lanzamiento y dos decisiones concretas aterrizan en escritorios reales. La primera pertenece a las industrias reguladas: durante años, la respuesta honesta a “¿podemos ejecutar modelos de frontera con nuestros datos más sensibles?” era una solución alternativa: modelos más pequeños, compromisos on-premise, o un formulario de aceptación de riesgos que nadie quería firmar. Un acelerador confidencial por hardware cambia esa conversación en la próxima renovación de nube y en cada RFP de IA que toque datos de salud, finanzas o gobierno: la pregunta ya no es si existe la IA cifrada en uso, sino cuánto cuesta y cuándo se envía. La segunda decisión trata sobre el valor predeterminado en sí. Permanecer enteramente en las GPU dominantes del mercado ha significado pagar la prima por escasez y hacer cola en el suministro; Google ahora ofrece una segunda fuente creíble cuyo negocio en la nube acaba de duplicarse año tras año, con una puerta de software abierta. Ambas decisiones, sin embargo, conllevan el mismo asterisco, y esta revista lo imprime en el mismo tamaño que las afirmaciones: Google no ha publicado precios, cada cifra de rendimiento en esta historia es propia del fabricante, y todavía no existe ningún benchmark independiente de ninguno de los dos nuevos sistemas. Bloomberg reporta que ambos sistemas llegarán en 2027 —reportado, no prometido. Evalúa ahora, por supuesto. Presupuesta como si el folleto fuera verdad, todavía no.
Lo que no está en duda es la velocidad. Una compañía que diseña su propia IA, la entrena en su propio silicio y ahora reconfigura ese silicio en cuatro sistemas empresariales en un solo año le está diciendo algo estructural al mercado: en la era de la IA, el chip no es un componente que compras. Es una estrategia que operas. El resto de la industria —tanto proveedores como compradores— ahora planifica en torno a ese hecho.
Las cifras de fondo
La octava generación no vive solo de la novedad. Google afirma que su stack de software nativo lidera las marcas de precio-rendimiento en los benchmarks InferenceX y AgentX — las cargas que importan en la era de los agentes: inferencia a escala y agentes de código con contexto largo. Construido con Supabase, la empresa de backend para plataformas, Google también reporta sus resultados de inferencia en MLPerf, el consorcio de medición de la industria. Y bajo el piso, las cifras se multiplican: combinado con el 8t y el 8i, el 8i Max eleva la capacidad HBM y el ancho de banda de memoria de un solo pod en múltiplos de hasta unas cinco y diez veces sobre la generación anterior, generación contra generación — de nuevo, la contabilidad del propio fabricante, y de nuevo impresa aquí exactamente como eso.
Qué emociona
- La velocidad como estrategia: cuatro sistemas empresariales en un año, porque el computador se construye alrededor del chip, no después de él.
- Seguridad en el silicio: el cómputo confidencial elimina la excusa más antigua para mantener cargas de trabajo sensibles fuera de la IA de frontera.
- Una puerta abierta: PyTorch se ejecuta de forma nativa a través del TorchTPU de código abierto — el costo de cambio cae hacia cero.
Qué vigilar
- Solo números del vendedor: cada cifra de rendimiento es de Google; aún no existe ningún benchmark independiente.
- Sin precios, se reporta para 2027: la disponibilidad proviene de los reportes de Bloomberg, no de un compromiso de Google.
- La gravedad de CUDA: el ecosistema titular todavía concentra la mayoría de las herramientas, el talento y los hábitos.
El problema del reloj
Nada de esto está todavía en un data center. Los sistemas construidos sobre el 8tx y el 8i Max llegan a los clientes en 2027, reporta Bloomberg — una línea de dos años entre el anuncio y la producción, mientras el incumbente despacha hoy. La respuesta de Google a esa brecha de tiempos es la puerta de software que abrió el mes pasado: TorchTPU es código abierto desde ahora, así que un equipo puede portar su stack de PyTorch, medir en las TPU de hoy y entrar a 2027 ya corriendo. Si ese tiempo basta para importar es la pregunta abierta que cuelga sobre cada hoja de ruta de IA enterprise escrita este trimestre — y la razón por la que la decisión de abajo lleva fecha.
Ficha técnica
La octava generación (Google, 9 nov 2026)
| Campo | Detalle |
| TPU 8t (abr 2026) | Potencia de entrenamiento para modelos fundacionales masivos — hasta 2,7x el rendimiento de entrenamiento de la generación anterior |
| TPU 8i (abr 2026) | Motor de razonamiento para inferencia en tiempo real — 80% mejor relación precio-rendimiento de inferencia vs. la generación anterior |
| TPU 8tx (nov 2026) | Inferencia confidencial y entrenamiento a pequeña escala; silicio 8t + hosts AMD EPYC de 5ª gen; cómputo confidencial reforzado por hardware; hasta 2x menor latencia que el 8t |
| TPU 8i Max (nov 2026) | Dos chips 8i en un paquete; doble cómputo, SRAM y ancho de banda HBM; mayor densidad de cómputo por rack |
TPU 8i Max, según lo reportado (Network World, de la sesión informativa de Google Cloud)
| Campo | Detalle |
| Capacidad HBM | 384 GB por paquete (aproximadamente un 33% más que el TPU 8i) |
| Ancho de banda de memoria | 17,2 TB/s (el doble que el 8i) |
| SRAM en el chip | 768 MB (el doble que el 8i) |
| Salvedad | Cifras reportadas de la sesión informativa del proveedor — no publicadas en el post de anuncio de Google |
El contexto del mercado
| Campo | Detalle |
| Clientes de TPU | Casi 100 — laboratorios de frontera, firmas de trading, minoristas, universidades (Google) |
| Google Cloud, Q3 2026 | Ingresos de 30.710 millones de dólares, un 103% más interanual; las ventas de sistemas TPU contribuyeron materialmente (Reuters, de los resultados de Alphabet) |
| Disponibilidad | Se reporta que ambos nuevos sistemas llegarán en 2027 (Bloomberg); Google no ha publicado precios |
| Fotografía | Superpod Ironwood (7ª generación) — la infraestructura de TPU instalada actual; los sistemas de gen-8 aún no están instalados en ninguna parte |
Fuentes
- Google, blog oficial (Amin Vahdat, 9 nov 2026): 'Introducing TPU 8tx and TPU 8i Max' — el año de cuatro sistemas, casi 100 clientes de TPU, rendimiento de la generación 8, cómputo confidencial del 8tx con hosts AMD EPYC de 5ª gen y hasta 2x menor latencia, paquete de doble chip del 8i Max duplicando el ancho de banda de cómputo, SRAM y HBM, TorchTPU y TPU Sync.
- Reuters (9 nov 2026): Ingresos de Google Cloud de 30.710 millones de dólares en el trimestre de septiembre, un 103% más interanual, con una contribución importante de las ventas de TPU; Bloomberg News reportó por primera vez las nuevas variantes, incluyendo la disponibilidad en 2027.
- Network World (9 nov 2026): Especificaciones del TPU 8i Max de la sesión informativa de Google Cloud — 384 GB de HBM, 17,2 TB/s de ancho de banda de memoria, 768 MB de SRAM.
- Foto: Google (blog oficial) — parte de un superpod Ironwood, la infraestructura TPU de séptima generación de Google. Los sistemas de octava generación anunciados el 9 de noviembre aún no están instalados; no se utilizó el arte de producto propio del anuncio.