
Lux estreia em 14.º no TOP500: a primeira fábrica de IA da Genesis Mission já está aberta — e metade das suas horas está à venda
Uma máquina do TOP500 que se comporta como uma nuvem e vende metade das suas horas: o Lux, construído pela HPE e pela AMD para Oak Ridge, é a primeira fábrica de IA dedicada da Genesis Mission — 4.032 GPUs MI355X sobre um tecido Ethernet de 800G, dentro de um laboratório nacional, aberta aos negócios.
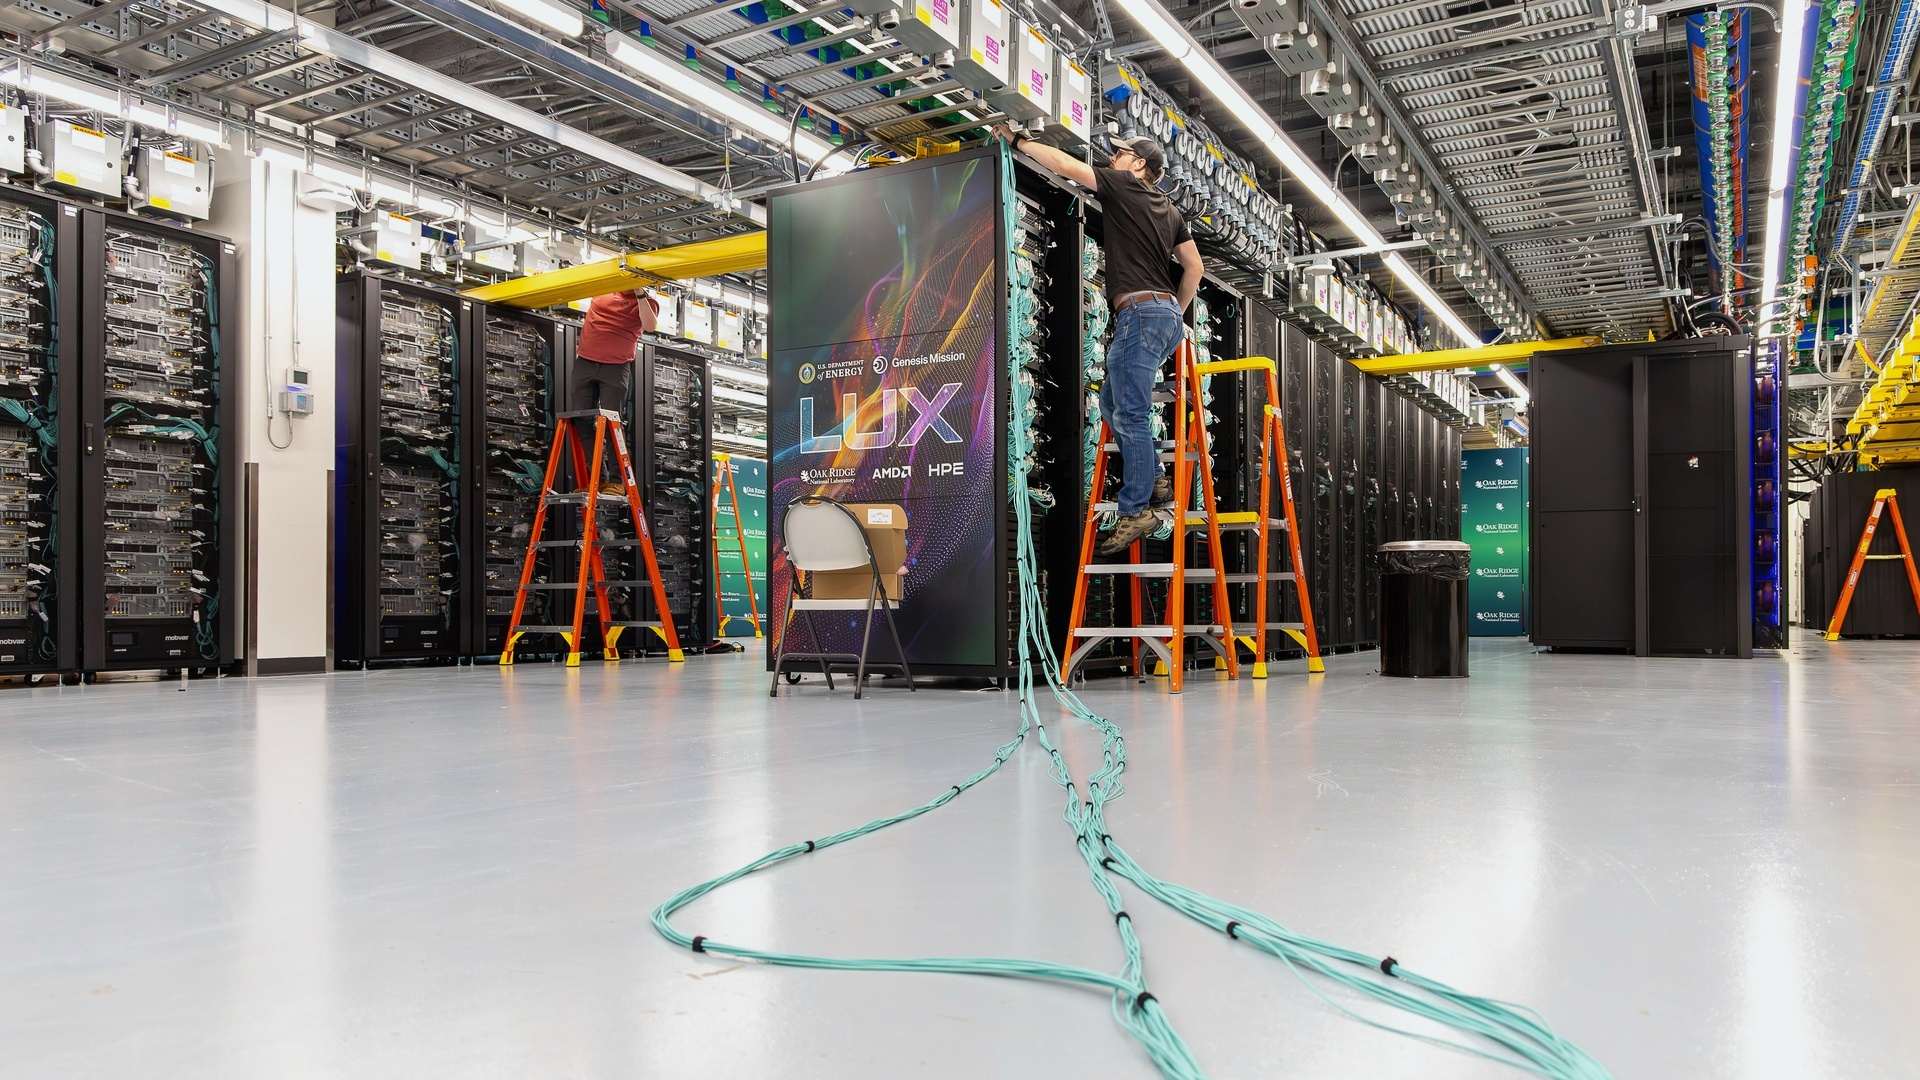
Foto: Oak Ridge National Laboratory — técnicos instalando e conectando os gabinetes LUX na Oak Ridge Leadership Computing Facility (OLCF). Página oficial do sistema na OLCF.
O supercomputador mais importante anunciado este ano não será medido só em flops. Na segunda-feira, 16 de novembro de 2026, na SC26 (Chicago), o Lux — o cluster de inteligência artificial codesenhado e co-construído pela HPE e pela AMD para o Laboratório Nacional de Oak Ridge (ORNL) — estreou no 14.º lugar do TOP500, a lista dos supercomputadores mais potentes do mundo, com 220,79 petaflops medidos no benchmark HPL (AMD). No mesmo dia, a AMD anunciou que o Lux já está aberto aos usuários científicos. Uma máquina entrar no ranking mundial em 14.º e abrir as portas no primeiro dia é notícia. O que faz do Lux um plano de época é tudo o que rodeia esse número: é o primeiro sistema de IA dedicado colocado em operação para a Genesis Mission do Departamento de Energia dos EUA (DOE), roda sobre Ethernet de 800 gigabits dentro de um laboratório nacional, comporta-se como uma nuvem — multitenant, com agendamento em Slurm e Kubernetes — e metade das suas horas anuais está, literalmente, à venda.

Uma estreia em 14.º — e uma porta já aberta
Os supercomputadores costumam chegar em etapas: instalação, aceitação, um lugar no ranking e, só depois, os usuários. O Lux comprimiu a sequência. A estreia no TOP500 e a abertura aos usuários científicos caíram na mesma segunda-feira, sob uma parceria público-privada entre a AMD e o DOE, com o sistema codesenhado e co-construído pela HPE e pela AMD para o ORNL (HPE; AMD). A AMD descreve o Lux como a primeira “fábrica de IA” dedicada dos Estados Unidos para a Genesis Mission — a iniciativa do DOE para acelerar a ciência com inteligência artificial — e a HPE o chama de primeiro sistema de IA dedicado colocado em operação projetado para essa missão. A precisão importa: o ORNL já opera o Frontier, a primeira máquina exascale. O Lux não é um Frontier maior. É outro tipo de máquina, construída primeiro para cargas de IA e oferecida aos usuários de outra maneira.
O próprio ranking merece uma leitura precisa. O 14.º lugar do TOP500 é medido em HPL, o benchmark tradicional de dupla precisão: 220,79 petaflops, segundo a AMD. Mas o Lux não foi projetado para vencer esse benchmark; foi projetado para treinar e executar modelos de IA em escala, e os números que a OLCF publica para o sistema são expressos nas precisões que a IA realmente usa: picos de 40 exaflops em FP4 e 20 exaflops em FP8, ao lado de 317 petaflops em FP64 para a simulação clássica (OLCF). Lidas em conjunto, as duas séries de números deixam clara a intenção do projeto: uma máquina de liderança cuja manchete já não é a métrica pela qual foi classificada.
A máquina, peça por peça
A plataforma de computação é o HPE ProLiant Compute XD685, com refrigeração líquida direta (HPE). Dentro de cada nó, os aceleradores são GPUs AMD Instinct MI355X — 288 GB de memória HBM3e por GPU a 8 TB/s de largura de banda, segundo a OLCF — acompanhadas por CPUs AMD EPYC. O sistema é organizado, na escala publicada pela OLCF, em 504 nós com oito aceleradores MI355X cada um: 4.032 GPUs no total (OLCF). As DPUs AMD Pensando cuidam do descarregamento do processamento de dados, e a pilha de software é o AMD ROCm (AMD). Cada nó leva mais de 24 TB de armazenamento NVMe local, e o sistema se conecta ao sistema de arquivos Lustre Orion da OLCF, com mais de 600 petabytes (OLCF).
Nenhum desses componentes é, sozinho, exótico em 2026 — e esse é exatamente o ponto que um comprador deve levar do Lux. A receita — uma plataforma de servidores de volume da HPE, uma GPU comercial com HBM muito grande, uma CPU comercial, DPUs para descarregamento e uma pilha de software aberta no ROCm — é a receita do data center de IA comercial, executada aqui com a escala e a disciplina de um laboratório nacional. O que um laboratório costumava construir como peça única, a indústria agora constrói como linha de produto.
A rede é a história: Ethernet de 800G dentro do laboratório
Para quem especifica infraestrutura, a linha mais consequente do anúncio é a da rede. O tecido do Lux é HPE Juniper Networking: switches QFX com suporte a 800G, balanceamento de carga avançado e gestão de congestionamento, operados através do HPE Networking Data Center Director — implantação, gestão e automação do ciclo de vida baseados em intenção (HPE). A HPE diz sem rodeios: o Lux é a primeira implementação de soluções HPE Networking em um laboratório nacional do DOE.
Vale pesar o que isso certifica. Os laboratórios nacionais são os clientes de rede mais exigentes do planeta: um trabalho de treinamento de IA que trava por congestionamento desperdiça o recurso mais escasso do prédio. Durante décadas, essa classe de tecido foi o território das interconexões especializadas. O Lux coloca nesse assento um tecido Ethernet — o da Juniper, a 800 gigabits, com a maquinaria de congestionamento para manter milhares de GPUs alimentadas — envolto em automação baseada em intenção, em vez de configuração artesanal. Se o Ethernet de 800G com balanceamento de carga avançado passar na aceitação em Oak Ridge, o argumento de que o treinamento sério de IA exige um tecido exótico fica muito mais difícil de sustentar numa revisão de projeto empresarial. O plano viaja: o mesmo padrão QFX + Director é o que a HPE vende às empresas que constroem suas próprias fábricas de IA, na escala que o orçamento permitir.
Um supercomputador que se pode alugar
O modelo de operação é a segunda metade do plano. O Lux é multitenant, com acesso em estilo nuvem, e agenda o trabalho com os dois sistemas que dividem o mundo moderno: o Slurm, o padrão do HPC, e o Kubernetes, o padrão da nuvem (OLCF). Uma só máquina, duas gramáticas: a computação em lotes dos supercomputadores para os laboratórios, e a orquestração de contêineres para quem chega do lado da nuvem.
E depois há a matemática da capacidade, publicada pela OLCF: 3,5 milhões de horas-nó por ano. Metade fica reservada para a Genesis Mission. A outra metade é para uso proprietário — pago, à tarifa de user facility do DOE. Os compromissos vão de seis meses a cinco anos e podem começar em qualquer mês; o mínimo proprietário é de 175.000 horas-nó por compromisso semestral, segundo o guia do usuário da OLCF. Traduzido para a linguagem de compras: o Departamento de Energia dos EUA vende tempo numa máquina do TOP500 como uma nuvem vende capacidade reservada — um mínimo definido, um prazo definido, uma lógica de tarifa publicada — com a diferença de que a capacidade em questão vive dentro do perímetro de segurança de Oak Ridge, ao lado de 600 petabytes de armazenamento Orion.
Para quem é? Os clientes óbvios são os que têm cargas de IA sensíveis demais, grandes demais ou sujeitas demais a controle de exportação para uma região de nuvem pública — e não conseguem justificar construir um cluster próprio de 4.032 GPUs. O Lux transforma essa decisão de construir ou comprar numa terceira opção: alugar a máquina da nação.
Segurança no nível do Frontier
Um supercomputador alugável dentro de um laboratório nacional só funciona se o modelo de segurança for explícito, e o da OLCF é: o Lux opera sob controles DOE Moderate — o mesmo nível do Frontier — e admite aplicações com controle de exportação, com controles Moderate-Enhanced nos planos para cargas como ITAR e PHI (OLCF). Essa combinação é a chave comercial de toda a oferta. Multitenant costuma significar um ambiente compartilhado de mínimo denominador comum; aqui significa infraestrutura compartilhada sob a linha de base de controle de um sistema exascale, com um roteiro para o nível reforçado de que as indústrias reguladas realmente precisam. Para um responsável de segurança que avalia capacidade de IA, esse parágrafo da ficha técnica pode importar mais do que os petaflops.
No que o Lux vai trabalhar primeiro
Os projetos da Genesis Mission já alocados ao Lux desenham a mistura de cargas pretendida (AMD). Primeiro, o projeto de usinas de fusão assistido por IA: trabalho intensivo em simulação e faminto por modelos, na fronteira entre o HPC e a IA. Segundo, uma fábrica de modelos fundacionais de IA para o desenvolvimento de materiais e a manufatura avançada: não um modelo, mas uma linha de produção de modelos — exatamente o que “fábrica de IA” deveria significar. Terceiro, a previsão do sistema terrestre: prever a disponibilidade de água, a vazão e a temperatura dos rios na região da Tennessee Valley Authority, o próprio quintal do laboratório. Fusão, fábricas e rios: energia, indústria e território, as três missões clássicas do DOE, cada uma reformulada como carga de IA.
As pessoas que assinam o anúncio o enquadram da mesma forma. Georgia Tourassi, diretora associada de Ciências da Computação e Computacionais do ORNL, chamou o Lux de “a primeira grande adição à infraestrutura de computação do DOE em apoio à Genesis Mission”, que transforma uma visão nacional em capacidade tangível para os pesquisadores (AMD). Thomas Zacharia, vice-presidente sênior de Setor Público Global e Parcerias Estratégicas da AMD, apontou para o modelo de parceria e para uma “pilha de IA aberta e soberana” que pesquisadores de todo o país podem usar (AMD). E Trish Damkroger, vice-presidente sênior e gerente geral de HPC & AI Infrastructure Solutions da HPE, sublinhou a entrega de engenharia: a HPE e seus parceiros, disse ela, “entregaram uma inovação de engenharia revolucionária para avançar os recursos de computação científica da nação” (HPE; AMD).
A parceria, e o caminho até o Discovery
O Lux não apareceu do nada. A HPE e a AMD o anunciaram há cerca de um ano, em 27 de outubro de 2025, junto ao Discovery — o sistema que sucederá o Frontier em Oak Ridge, previsto para 2028 e construído sobre a plataforma HPE Cray GX5000 com aceleradores MI430X da AMD. Lido em sequência, o plano é uma escada: o Frontier provou a exascale; o Lux industrializa agora, em 2026, a capacidade de IA dedicada; o Discovery fundirá as duas linhas no fim da década. O compromisso da HPE não é só engenharia: a empresa colocou um investimento em espécie de US$ 37 milhões no programa (HPE).
Há até um sinal precoce do ecossistema que se forma em torno da máquina. No resumo da SC26 da AMD, o white paper do Pelagos — uma ferramenta aberta da AMD e da IBM para a decodificação de correção de erros quânticos — relata um escalonamento de 6,23× de 1 para 8 GPUs MI355X executado sobre o Lux. Letra miúda, significado grande: terceiros já publicam resultados medidos no sistema na sua primeira semana de vida pública.
O que isto significa se você especifica infraestrutura
Retirado o cenário do laboratório nacional, o Lux se lê como uma arquitetura de referência com um modelo de preços anexado. Um: a fábrica de IA já é um padrão de produto, não um projeto de pesquisa — servidores de volume, silício comercial, refrigeração líquida, ROCm, montado por um integrador. Dois: o Ethernet a 800G, com gestão séria de congestionamento e operação baseada em intenção, tem uma implantação de referência num laboratório nacional; os arquitetos podem citar Oak Ridge na revisão de projeto. Três: o modelo de acesso — multitenant, Slurm e Kubernetes lado a lado, capacidade vendida em horas-nó com mínimos e prazos — é a gramática da nuvem aplicada a hardware soberano, e será copiado por toda instituição que possua mais máquina do que usa.
E quatro, o ponto mais silencioso e maior: um sistema do TOP500 cuja segunda maior alocação é uma oferta comercial muda o que “capacidade” significa para todos os outros. Uma empresa que precisa de 175.000 horas-nó de computação classe MI355X sob controles DOE Moderate já não tem de construir, pedir emprestado nem esperar. Tem de escrever uma proposta e um cheque. O Lux estreou em 14.º no TOP500. A sua verdadeira estreia é como plano — de como as fábricas de IA serão construídas, conectadas em rede e vendidas.
𝐋𝐄𝐈𝐀 𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐔𝐈𝐓𝐀 𝐄𝐌 thebuyerspulse.com/pt/
Fontes
- HPE (comunicado de imprensa, novembro de 2026): “HPE-built Lux AI cluster debuts at No. 14 on the TOP500” — codesenho e co-construção com a AMD para o ORNL; HPE ProLiant Compute XD685 com refrigeração líquida direta; switches QFX da HPE Juniper Networking com suporte a 800G, balanceamento de carga avançado e gestão de congestionamento; HPE Networking Data Center Director (implantação, gestão e automação do ciclo de vida baseados em intenção); primeira implementação de soluções HPE Networking num laboratório nacional do DOE; investimento em espécie da HPE de US$ 37 milhões; Trish Damkroger, vice-presidente sênior e gerente geral de HPC & AI Infrastructure Solutions da HPE.
- AMD (comunicado, 16 de novembro de 2026): “AMD-powered Lux supercomputer opens to scientific users” — 14.º no TOP500 com 220,79 petaflops (HPL); aberto aos usuários científicos; primeira fábrica de IA dedicada dos EUA para a Genesis Mission; CPUs AMD EPYC, GPUs Instinct MI355X, rede Pensando e software ROCm num sistema construído pela HPE; alocações da Genesis Mission (projeto de usinas de fusão, fábrica de modelos fundacionais para materiais e manufatura avançada, previsão do sistema terrestre para a região da Tennessee Valley Authority); citações de Thomas Zacharia (vice-presidente sênior de Setor Público Global e Parcerias Estratégicas da AMD) e Georgia Tourassi (diretora associada de Ciências da Computação e Computacionais do ORNL).
- AMD (resumo da SC26, novembro de 2026): “SC26: AMD expands frontier scientific computing” — incluindo o resultado do white paper do Pelagos (ferramenta aberta da AMD e da IBM para decodificação de correção de erros quânticos), que relata escalonamento de 6,23× de 1 para 8 GPUs MI355X sobre o Lux.
- Oak Ridge Leadership Computing Facility (OLCF), página do sistema Lux e guia do usuário: 504 nós × 8 AMD Instinct MI355X = 4.032 GPUs; MI355X com 288 GB de HBM3e a 8 TB/s; picos de 40 exaflops FP4, 20 exaflops FP8 e 317 petaflops FP64; mais de 24 TB de NVMe por nó; sistema de arquivos Lustre Orion acima de 600 PB; multitenant com acesso em estilo nuvem e agendamento com Slurm e Kubernetes; 3,5 milhões de horas-nó por ano, metade para a Genesis Mission e metade para uso proprietário pago à tarifa de user facility do DOE; compromissos de seis meses a cinco anos com início em qualquer mês e mínimo proprietário de 175.000 horas-nó por compromisso semestral; controles DOE Moderate (o mesmo nível do Frontier), aplicações com controle de exportação admitidas e Moderate-Enhanced (ITAR/PHI) nos planos.
- Contexto (HPE e AMD, 27 de outubro de 2025): Lux anunciado junto ao Discovery; o Discovery sucederá o Frontier no ORNL em 2028, construído sobre a plataforma HPE Cray GX5000 com aceleradores MI430X da AMD.
- Vídeo: Oak Ridge National Laboratory, “Inside Lux: Powering the Future of the Genesis Mission” (YouTube, canal oficial do ORNL, 2:02) — Scott Atchley, diretor de tecnologia do National Center for Computational Sciences. Produção do ORNL, o laboratório do DOE operado pela UT-Battelle; incorporado através do reprodutor oficial do YouTube (youtube-nocookie). Não é redistribuído: no LinkedIn a matéria traz o link para este artigo e para o vídeo oficial (produção da contratada UT-Battelle sob a licença padrão do YouTube, não é domínio público).
- Foto: Oak Ridge National Laboratory, via a página do sistema Lux da OLCF (arquivo 26AH-8605, 3000×2000) — técnicos instalando e conectando os gabinetes LUX na OLCF.