
Los racks detrás del modelo abierto de frontera de China: LongCat-2.5 corre sobre Huawei, no sobre Nvidia
Meituan liberó los pesos completos de LongCat-2.5, un modelo de 1,6 billones de parámetros para agentes de horizonte largo, bajo la licencia MIT. Su propia documentación describe el entrenamiento con aceleradores chinos y un despliegue de muestra sobre 194 chips Huawei Ascend Atlas A2, sin ninguna GPU de Nvidia en la ruta oficial.
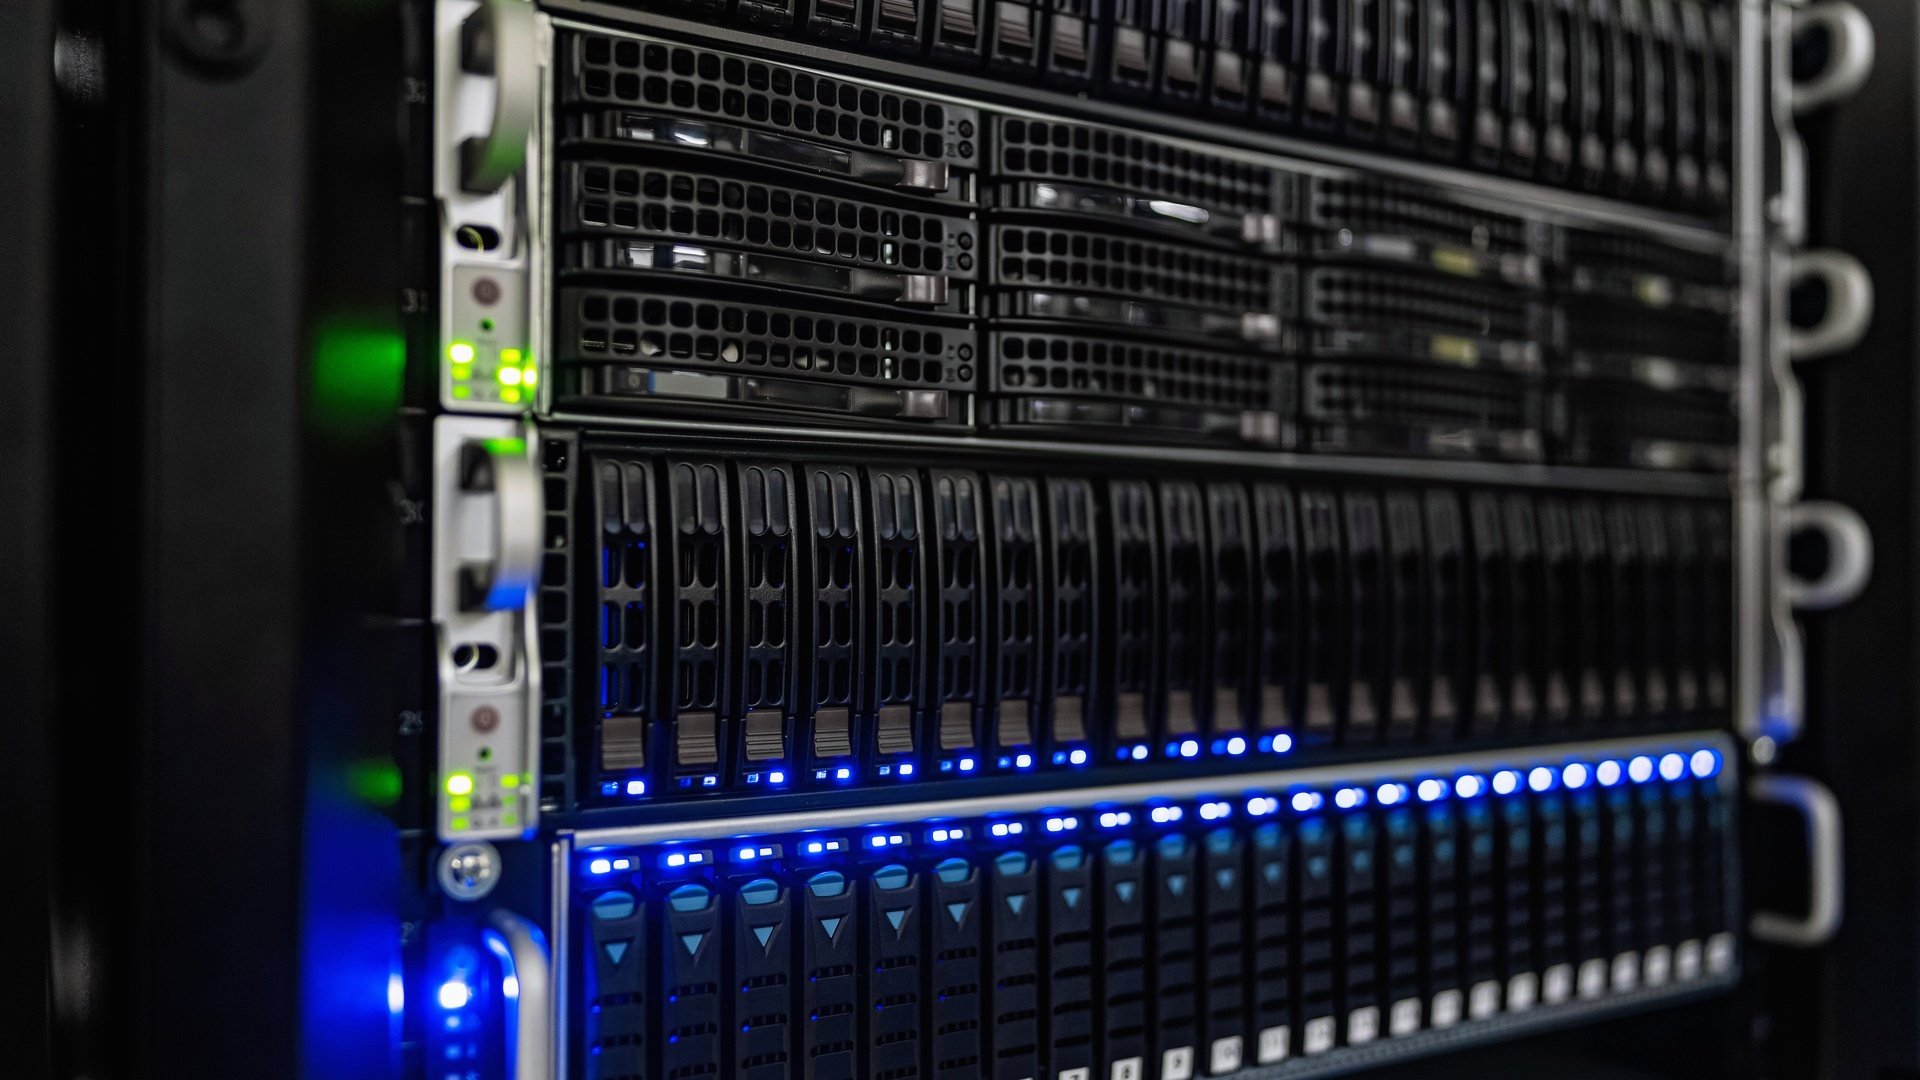
Foto: NOIRLab/NSF/AURA/T. Slovinský — «NOIRLab HQ Server Racks» (2022), CC BY 4.0, vía Wikimedia Commons.
La fotografía que abre esta nota es un primer plano de las máquinas mismas: unidades de servidor encendidas apiladas en un rack, bahías de disco numeradas, rejillas de ventilación y filas de luces de estado azules y verdes. No es la instalación de Meituan, y esta revista no afirma lo contrario. Pero es la imagen correcta para esta historia, porque la noticia de LongCat-2.5 no trata, en el fondo, de un chatbot. Trata de sobre qué máquinas puede apoyarse un modelo de inteligencia artificial de frontera. Meituan, el gigante chino de reparto de comida y servicios locales, liberó los pesos completos de un modelo de 1,6 billones de parámetros construido para agentes autónomos, y su propia documentación describe un modelo entrenado con aceleradores chinos y desplegado sobre hardware de Huawei, sin ninguna GPU de Nvidia en la ruta oficial.
El momento agudizó el contraste. La liberación de los pesos recibió amplia cobertura internacional el 15 de noviembre, cuando The Decoder contó la historia con un titular que decía el punto de forma directa: un modelo agente de 1,6 billones de parámetros que nunca tocó una GPU de Nvidia. Esa cobertura llega en la semana en que Nvidia presenta sus resultados trimestrales y enfrenta una crisis abierta de gobernanza en torno a su liderazgo: una semana en la que el supuesto por defecto de la industria —que la IA seria corre sobre silicio de Nvidia— está siendo cuestionado desde dos direcciones a la vez. LongCat-2.5 es la dirección del hardware en esa pregunta, formulada en documentación y no en una frase de comunicado.
Qué se liberó y cuándo: la cronología real
No es un lanzamiento de hoy, y la precisión con las fechas importa porque varias coberturas tempranas las comprimieron. Meituan presentó LongCat-2.5 el 2 de noviembre de 2026. El repositorio de Hugging Face, meituan-longcat/LongCat-2.5, se creó el 4 de noviembre. El 10 de noviembre, Meituan anunció que los pesos quedaban en código abierto bajo la licencia MIT, con permiso explícito para inferencia comercial, despliegue y entrenamiento secundario sin autorización adicional. El punto de control completo es grande por cualquier medida: unos 3,56 terabytes de archivos de pesos en BF16, repartidos en 194 fragmentos safetensors, junto a un repositorio separado para la versión cuantizada de 4 bits. El 15 de noviembre es cuando la liberación llegó a la prensa tecnológica amplia, con The Decoder al frente: una segunda ola de atención, no la liberación misma.
Una curiosidad de metadatos merece una sola línea, atribuida a su fuente: la contabilidad de tensores de la propia Hugging Face suma unos 1,78 billones de parámetros almacenados, frente a los 1,6 billones que Meituan declara en la ficha. Meituan no ha conciliado ambas cifras; quien planifique almacenamiento debería dimensionar desde los archivos reales, no desde el titular.
El modelo: un sistema multimodal nativo para trabajo agente de horizonte largo
LongCat-2.5 es un modelo de mezcla de expertos, lo que significa que, aunque la red completa guarda 1,6 billones de parámetros, solo un subconjunto de sus subredes especializadas —unos 48.000 millones de parámetros— se activa por cada token que procesa. Es multimodal de forma nativa: la información visual se convierte en tokens discretos y se procesa en el mismo espacio compartido que el texto, de modo que el modelo lee capturas de pantalla, gráficos e imágenes, y acepta video por URL, junto al texto ordinario. El objetivo de diseño, en la descripción de Meituan, es el agente de horizonte largo: software que resuelve tareas de varios pasos de forma autónoma durante sesiones extendidas, en particular de programación —construir y reparar bases de código completas, operar una línea de comandos, buscar información y usar herramientas— en lugar de responder preguntas sueltas.
La API alojada refleja ese objetivo. Ofrece una ventana de contexto de un millón de tokens, admite un modo de razonamiento paso a paso y un modo más rápido sin razonamiento, y se expone mediante extremos compatibles con las convenciones principales de API. Nada de eso es inusual por sí solo a fines de 2026. Lo inusual es la pila que hay debajo.
El hardware es la historia: entrenado sin Nvidia
Según la documentación de Meituan, tal como la reportó The Decoder el 15 de noviembre, LongCat-2.5 se entrenó íntegramente sobre hardware chino, sin GPU de Nvidia en el proceso de entrenamiento. La afirmación tiene un antecesor documentado: Meituan afirma que entrenó LongCat-2.0, el modelo sobre el que se construye la versión 2.5, íntegramente en un clúster de más de 50.000 chips de IA chinos. La propia ficha del modelo 2.5 habla de optimizaciones de infraestructura sobre aceleradores de IA nacionales, y su única ruta oficial de despliegue es una ruta NPU —a través de la pila de servicio SGLang-FluentLLM de Meituan—, sin ninguna receta publicada para hardware de Nvidia.
La guía de despliegue es donde la afirmación se vuelve concreta y comprobable. Meituan cuantiza los pesos de los expertos y las activaciones del modelo a precisión de 4 bits —el esquema W4A4 documentado en la ficha—, un formato que los aceleradores chinos procesan de forma nativa en INT4. Frente a una base de 8 bits, Meituan reporta un rendimiento de prellenado 43,3 % mayor y un rendimiento de decodificación 42,77 % mayor en sus propias pruebas de estrés en línea; son cifras de la empresa, tomadas de su propia ficha, y así se etiquetan cada vez que esta revista las cita. La configuración de muestra de auto-alojamiento construida sobre esa cuantización corre sobre 194 aceleradores Huawei Ascend de la serie Atlas A2, divididos por función: 2 aceleradores se encargan del procesamiento de imágenes, 64 de la ingestión de prompts y 128 de la generación de respuestas. No existe una guía equivalente para GPU de Nvidia: ni una nota que diga que no se admite, simplemente ninguna guía.
Ficha de datos
LongCat-2.5, según la ficha oficial de Meituan
| Campo | Detalle |
| Desarrollador | Meituan (equipo LongCat) |
| Presentación | 2 de noviembre de 2026 |
| Pesos abiertos | Anunciado el 10 de noviembre de 2026, bajo licencia MIT (repositorio creado el 4 de noviembre) |
| Arquitectura | Mezcla de expertos multimodal nativa |
| Parámetros | 1,6 billones totales declarados; ~48.000 millones activos por token (los metadatos de Hugging Face suman ~1,78 billones almacenados) |
| Contexto | 1 millón de tokens (API alojada) |
| Tamaño del punto de control | ~3,56 TB en BF16; versión W4A4 de 4 bits por separado |
| Hardware de entrenamiento | Aceleradores chinos en todo el proceso, según Meituan vía The Decoder; sin GPU de Nvidia |
| Despliegue de muestra | 194 Huawei Ascend Atlas A2: 2 imagen · 64 ingestión · 128 generación |
| Precio de API (promocional) | $0,30 por millón de tokens de entrada · $1,20 de salida · $0,006 de entrada en caché |
La cifra de referencia, con su dueño adjunto
La cifra que más viajó es una puntuación de referencia: 88,4 en Terminal Bench v2.1, una prueba de cómo un agente resuelve tareas reales en un entorno de línea de comandos, frente a 89,1 de Claude Opus 5 de Anthropic en la misma tabla. Leída con cuidado, la propia tabla aporta la cautela. La ficha de Meituan declara que las puntuaciones medidas internamente son «solo indicativas», y las puntuaciones rivales de su comparación se citan de informes públicos en lugar de medirse en un arnés común. Ningún laboratorio independiente había reproducido el 88,4 en la cobertura publicada hasta el 15 de noviembre, y los modelos rivales más nuevos no figuran en la comparación. La afirmación honesta es más estrecha y aun así significativa: según las mediciones de su propio desarrollador, etiquetadas con claridad como propias, un modelo chino abierto se sitúa a un punto de un modelo estadounidense cerrado de primer nivel en una prueba de agentes. Si se mantiene bajo pruebas independientes es una pregunta que responderán las próximas semanas; que los pesos sean públicos significa que cualquiera con el hardware puede hacer la comprobación.
El precio, y lo que cambia y lo que no
Para los equipos que no quieren mover 3,56 terabytes, Meituan también vende acceso. La tarifa promocional de la API es de $0,30 por millón de tokens de entrada y $1,20 por millón de tokens de salida, con la entrada en caché a $0,006 por millón: una tarifa por tiempo limitado, declarada como tal por la empresa. Precios así reajustan las expectativas sobre lo que deberían costar las cargas de trabajo de agentes, y son parte de por qué la liberación atrajo atención más allá de la comunidad de pesos abiertos. Pero la licencia MIT es el hecho estructural: los pesos pueden descargarse, modificarse, ajustarse y ejecutarse comercialmente sin pedirle nada a Meituan, sobre el hardware que la licencia no dicta. La ruta de hardware que Meituan documenta resulta ser, simplemente, la de Huawei.
Lo que esto no demuestra
Tres cautelas pertenecen al registro. Primera: la afirmación sobre el hardware de entrenamiento es de Meituan, reportada por The Decoder desde la documentación de la empresa; las propias publicaciones de la empresa describen aceleradores nacionales sin nombrar un proveedor para el entrenamiento mismo —el nombre de Huawei es explícito en la guía de despliegue, que es una afirmación distinta, y esta nota mantiene ambas separadas—. Segunda: el auto-alojamiento sigue siendo una empresa de sala de servidores: un punto de control de varios terabytes y un despliegue de referencia de 194 aceleradores no son un fin de semana de aficionado, diga lo que diga la licencia. Tercera: una tabla de referencias publicada por el propio desarrollador de un modelo es un punto de partida para la verificación, no su conclusión: el mismo estándar que esta revista aplica a cada proveedor, en cada país.
Lo que queda, tras las cautelas, es el hecho al que apunta la fotografía. Durante una década, la geografía del cómputo avanzado de IA ha tenido un solo centro: aceleradores de diseño estadounidense, fabricados en una cadena de suministro concentrada y exportados bajo controles cada vez más estrictos. LongCat-2.5 es evidencia documentada —en una ficha pública, una guía de despliegue pública y un repositorio público que cualquiera puede inspeccionar— de un modelo de escala de frontera cuyo ciclo de vida oficial completo, entrenamiento y servicio por igual, corre en otro lugar. Los racks de la fotografía son anónimos. Los de la guía de Meituan tienen nombre, número y reparto de funciones: 194 aceleradores Huawei Ascend Atlas A2, y ni una sola GPU de Nvidia en el documento.
𝐂𝐎𝐍𝐒𝐈𝐆𝐔𝐄 𝐋𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐈𝐒 𝐄𝐍 thebuyerspulse.com/es/
Fuentes
- Meituan LongCat, ficha oficial del modelo: meituan-longcat/LongCat-2.5 en Hugging Face (leída en vivo el 15 de noviembre de 2026): 1,6 billones de parámetros totales, ~48.000 millones activados por token, MoE multimodal nativo, cuantización W4A4 (+43,3 % de rendimiento de prellenado frente a W8A8, pruebas propias de Meituan), despliegue solo NPU vía SGLang-FluentLLM, tabla de evaluación con la nota de que las puntuaciones internas son «solo indicativas» (Terminal Bench v2.1: LongCat-2.5 88,4; Claude Opus 5 89,1, citado), licencia MIT.
- Blog oficial de LongCat (longcat.ai), «Introducing LongCat-2.5»: presentación del modelo el 2 de noviembre de 2026 y anuncio de código abierto de Meituan del 10 de noviembre de 2026 (pesos bajo MIT; repositorio creado el 4 de noviembre de 2026; ~3,56 TB en BF16; los metadatos de Hugging Face suman ~1,78 billones de parámetros almacenados).
- The Decoder, 15 de noviembre de 2026: «Meituan releases a 1.6 trillion parameter agent model that never touched an Nvidia GPU»: entrenamiento íntegramente sobre hardware chino; LongCat-2.0 entrenado en más de 50.000 chips de IA chinos; despliegue de muestra de 194 aceleradores Huawei Ascend Atlas A2 (2 imagen · 64 ingestión · 128 generación); sin guía para Nvidia; precios promocionales de API.
- Foto: NOIRLab/NSF/AURA/T. Slovinský, «NOIRLab HQ Server Racks» (2022), CC BY 4.0, vía Wikimedia Commons (File:NOIRLab HQ Server Racks (6V6A0402-CC).jpg; original 5472×3648). La instalación fotografiada es ilustrativa y no se identifica como la de Meituan.