
Lux debuta en el n.º 14 del TOP500: la primera fábrica de IA de la Genesis Mission ya está abierta — y la mitad de sus horas está a la venta
Una máquina del TOP500 que se comporta como una nube y vende la mitad de sus horas: Lux, construida por HPE y AMD para Oak Ridge, es la primera fábrica de IA dedicada de la Genesis Mission — 4.032 GPU MI355X sobre un tejido Ethernet de 800G, dentro de un laboratorio nacional, abierta al negocio.
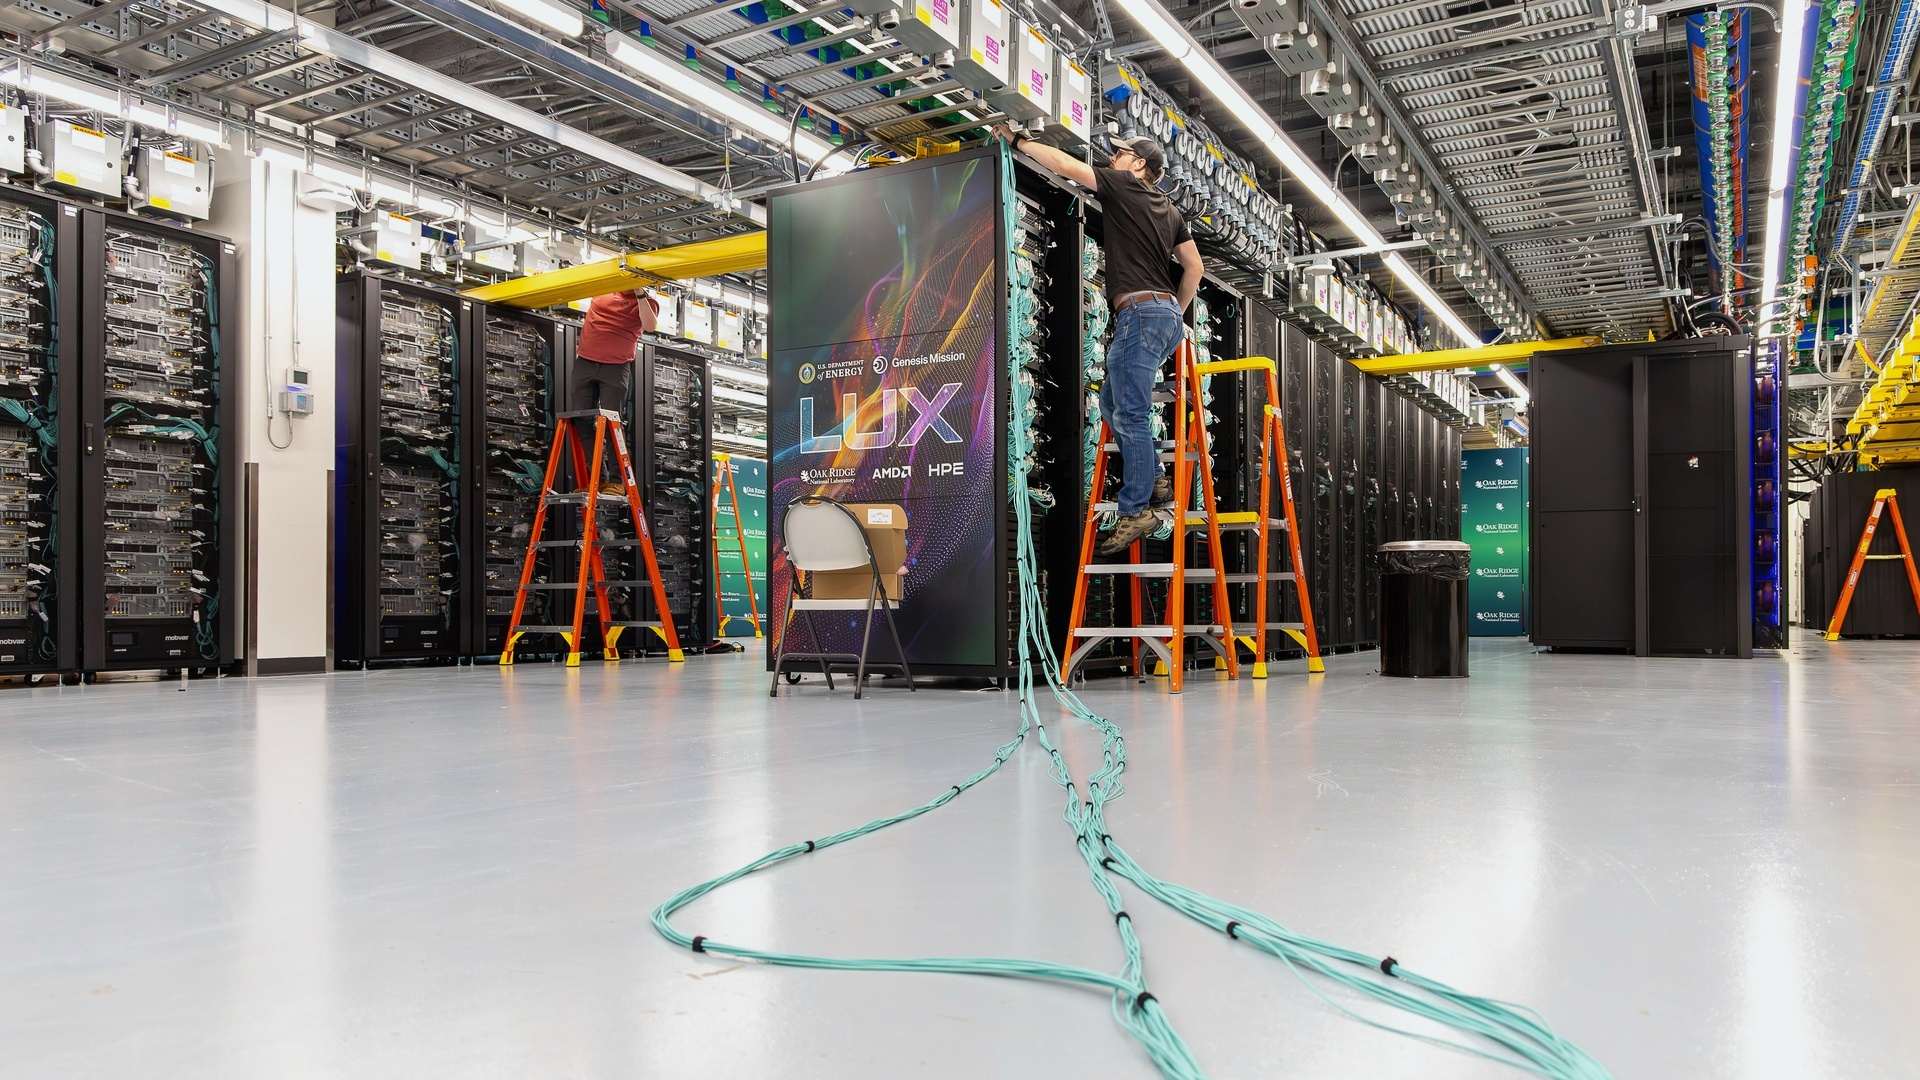
Foto: Oak Ridge National Laboratory — técnicos instalando y conectando los gabinetes LUX en la Oak Ridge Leadership Computing Facility (OLCF). Página oficial del sistema en OLCF.
La supercomputadora más importante anunciada este año no se medirá solo en flops. El lunes 16 de noviembre de 2026, en SC26 (Chicago), Lux — el clúster de inteligencia artificial codiseñado y co-construido por HPE y AMD para el Laboratorio Nacional de Oak Ridge (ORNL) — debutó en el n.º 14 del TOP500, la lista de las supercomputadoras más potentes del mundo, con 220,79 petaflops medidos en el benchmark HPL (AMD). El mismo día, AMD anunció que Lux ya está abierto a los usuarios científicos. Que una máquina entre al ranking mundial en el n.º 14 y abra sus puertas el primer día es noticia. Lo que convierte a Lux en un plano de época es todo lo que rodea esa cifra: es el primer sistema de IA dedicado puesto en línea para la Genesis Mission del Departamento de Energía de EE. UU. (DOE), corre sobre Ethernet de 800 gigabits dentro de un laboratorio nacional, se comporta como una nube — multitenant, con planificación en Slurm y Kubernetes — y la mitad de sus horas anuales está, literalmente, a la venta.

Un debut en el n.º 14 — y una puerta ya abierta
Las supercomputadoras suelen llegar por etapas: instalación, aceptación, un puesto en el ranking y, solo después, los usuarios. Lux comprimió la secuencia. El debut en el TOP500 y la apertura a los usuarios científicos cayeron el mismo lunes, bajo una alianza público-privada entre AMD y el DOE, con el sistema codiseñado y co-construido por HPE y AMD para ORNL (HPE; AMD). AMD describe a Lux como la primera «fábrica de IA» dedicada de Estados Unidos para la Genesis Mission — la iniciativa del DOE para acelerar la ciencia con inteligencia artificial — y HPE la llama el primer sistema de IA dedicado puesto en línea diseñado para esa misión. La precisión importa: ORNL ya opera Frontier, la primera máquina exascale. Lux no es un Frontier más grande. Es otro tipo de máquina, construida primero para cargas de IA y ofrecida a los usuarios de otra manera.
El ranking mismo merece una lectura precisa. El n.º 14 del TOP500 se mide en HPL, el benchmark tradicional de doble precisión: 220,79 petaflops, según AMD. Pero Lux no fue diseñada para ganar ese benchmark; fue diseñada para entrenar y ejecutar modelos de IA a escala, y las cifras propias que OLCF publica para el sistema se expresan en las precisiones que la IA realmente usa: picos de 40 exaflops en FP4 y 20 exaflops en FP8, junto a 317 petaflops en FP64 para la simulación clásica (OLCF). Leídas en conjunto, las dos series de cifras dejan clara la intención del diseño: una máquina de liderazgo cuyo titular ya no es la métrica con la que fue clasificada.
La máquina, pieza por pieza
La plataforma de cómputo es el HPE ProLiant Compute XD685, con refrigeración líquida directa (HPE). Dentro de cada nodo, los aceleradores son GPU AMD Instinct MI355X — 288 GB de memoria HBM3e por GPU a 8 TB/s de ancho de banda, según OLCF — acompañadas por CPU AMD EPYC. El sistema se organiza, a la escala que publica OLCF, en 504 nodos con ocho aceleradores MI355X cada uno: 4.032 GPU en total (OLCF). Las DPU AMD Pensando se encargan de la descarga de procesamiento de datos, y la pila de software es AMD ROCm (AMD). Cada nodo lleva más de 24 TB de almacenamiento NVMe local, y el sistema se conecta al sistema de archivos Lustre Orion de OLCF, de más de 600 petabytes (OLCF).
Ninguno de esos componentes es, por sí solo, exótico en 2026 — y ese es exactamente el punto que un comprador debe llevarse de Lux. La receta — una plataforma de servidores de volumen de HPE, una GPU comercial con HBM muy grande, una CPU comercial, DPU para la descarga y una pila de software abierta en ROCm — es la receta del centro de datos de IA comercial, ejecutada aquí con la escala y la disciplina de un laboratorio nacional. Lo que un laboratorio solía construir como pieza única, la industria ahora lo construye como línea de producto.
La red es la historia: Ethernet de 800G dentro del laboratorio
Para quien especifica infraestructura, la línea más consecuente del anuncio es la de la red. El tejido de Lux es HPE Juniper Networking: switches QFX que soportan 800G, con balanceo de carga avanzado y gestión de congestión, operados a través de HPE Networking Data Center Director — despliegue, gestión y automatización del ciclo de vida basados en intención (HPE). HPE lo dice sin rodeos: Lux es la primera implementación de soluciones HPE Networking en un laboratorio nacional del DOE.
Conviene sopesar lo que eso certifica. Los laboratorios nacionales son los clientes de red más exigentes del planeta: un trabajo de entrenamiento de IA que se frena por congestión desperdicia el recurso más escaso del edificio. Durante décadas, esa clase de tejido fue el territorio de las interconexiones especializadas. Lux pone en ese asiento un tejido Ethernet — el de Juniper, a 800 gigabits, con la maquinaria de congestión para mantener alimentadas a miles de GPU — envuelto en automatización basada en intención en vez de configuración artesanal. Si el Ethernet de 800G con balanceo de carga avanzado pasa la aceptación en Oak Ridge, el argumento de que el entrenamiento serio de IA exige un tejido exótico se vuelve mucho más difícil de sostener en una revisión de diseño empresarial. El plano viaja: el mismo patrón QFX + Director es el que HPE vende a las empresas que construyen sus propias fábricas de IA, a la escala que su presupuesto permita.
Una supercomputadora que se puede alquilar
El modelo de operación es la segunda mitad del plano. Lux es multitenant, con acceso de tipo nube, y planifica el trabajo con los dos sistemas que se reparten el mundo moderno: Slurm, el estándar del HPC, y Kubernetes, el estándar de la nube (OLCF). Una sola máquina, dos gramáticas: el cómputo por lotes de las supercomputadoras para los laboratorios, y la orquestación de contenedores para quien llega desde el lado de la nube.
Y luego está la matemática de la capacidad, publicada por OLCF: 3,5 millones de horas-nodo al año. La mitad queda reservada para la Genesis Mission. La otra mitad es para uso propietario — pagado, a la tarifa de user facility del DOE. Los compromisos van de seis meses a cinco años y pueden empezar en cualquier mes; el mínimo propietario es de 175.000 horas-nodo por compromiso semestral, según la guía de usuario de OLCF. Traducido al lenguaje de compras: el Departamento de Energía de EE. UU. vende tiempo en una máquina del TOP500 como una nube vende capacidad reservada — un mínimo definido, un plazo definido, una lógica de tarifa publicada — con la diferencia de que la capacidad en cuestión vive dentro del perímetro de seguridad de Oak Ridge, junto a 600 petabytes de almacenamiento Orion.
¿Para quién es? Los clientes obvios son los que tienen cargas de IA demasiado sensibles, demasiado grandes o demasiado sujetas a control de exportación para una región de nube pública — y no pueden justificar construir un clúster propio de 4.032 GPU. Lux convierte esa decisión de construir o comprar en una tercera opción: alquilar la máquina de la nación.
Seguridad al nivel de Frontier
Una supercomputadora alquilable dentro de un laboratorio nacional solo funciona si el modelo de seguridad es explícito, y el de OLCF lo es: Lux opera bajo controles DOE Moderate — el mismo nivel que Frontier — y admite aplicaciones con control de exportación, con controles Moderate-Enhanced en planes para cargas como ITAR y PHI (OLCF). Esa combinación es la llave comercial de toda la oferta. Multitenant suele significar un entorno compartido de mínimo común denominador; aquí significa infraestructura compartida bajo la línea base de control de un sistema exascale, con una hoja de ruta hacia el nivel reforzado que las industrias reguladas realmente necesitan. Para un responsable de seguridad que evalúa capacidad de IA, ese párrafo de la ficha técnica puede importar más que los petaflops.
En qué trabajará Lux primero
Los proyectos de la Genesis Mission ya asignados a Lux dibujan la mezcla de cargas buscada (AMD). Primero, el diseño de plantas de fusión asistido por IA: trabajo intensivo en simulación y hambriento de modelos, en la frontera entre el HPC y la IA. Segundo, una fábrica de modelos fundacionales de IA para el desarrollo de materiales y la manufactura avanzada: no un modelo, sino una línea de producción de modelos — exactamente lo que se supone que significa «fábrica de IA». Tercero, la predicción del sistema terrestre: pronosticar la disponibilidad de agua, el caudal y la temperatura de los ríos en la región de la Tennessee Valley Authority, el propio patio del laboratorio. Fusión, fábricas y ríos: energía, industria y territorio, las tres misiones clásicas del DOE, cada una replanteada como carga de IA.
Las personas que firman el anuncio lo encuadran igual. Georgia Tourassi, directora asociada de Ciencias de la Computación y Computacionales de ORNL, llamó a Lux «la primera gran adición a la infraestructura de cómputo del DOE en apoyo de la Genesis Mission», que convierte una visión nacional en capacidad tangible para los investigadores (AMD). Thomas Zacharia, vicepresidente sénior de Sector Público Global y Alianzas Estratégicas de AMD, apuntó al modelo de alianza y a una «pila de IA abierta y soberana» que los investigadores de todo el país pueden usar (AMD). Y Trish Damkroger, vicepresidenta sénior y gerenta general de HPC & AI Infrastructure Solutions de HPE, subrayó la entrega de ingeniería: HPE y sus socios, dijo, han «entregado una innovación de ingeniería revolucionaria para avanzar los recursos de computación científica de la nación» (HPE; AMD).
La alianza, y el camino a Discovery
Lux no apareció de la nada. HPE y AMD lo anunciaron hace aproximadamente un año, el 27 de octubre de 2025, junto a Discovery — el sistema que sucederá a Frontier en Oak Ridge, previsto para 2028 y construido sobre la plataforma HPE Cray GX5000 con aceleradores MI430X de AMD. Leído en secuencia, el plan es una escalera: Frontier probó la exaescala; Lux industrializa ahora, en 2026, la capacidad de IA dedicada; Discovery fusionará ambas líneas al final de la década. El compromiso de HPE no es solo ingeniería: la compañía puso una inversión en especie de US$37 millones en el programa (HPE).
Hay incluso una señal temprana del ecosistema que se forma alrededor de la máquina. En el resumen de SC26 de AMD, el white paper de Pelagos — una herramienta abierta de AMD e IBM para la decodificación de corrección de errores cuánticos — reporta un escalado de 6,23× de 1 a 8 GPU MI355X ejecutándose sobre Lux. Letra pequeña, significado grande: terceros ya publican resultados medidos en el sistema en su primera semana de vida pública.
Qué significa si usted especifica infraestructura
Quitado el escenario del laboratorio nacional, Lux se lee como una arquitectura de referencia con un modelo de precios adjunto. Uno: la fábrica de IA ya es un patrón de producto, no un proyecto de investigación — servidores de volumen, silicio comercial, refrigeración líquida, ROCm, ensamblado por un integrador. Dos: el Ethernet a 800G, con gestión seria de la congestión y operación basada en intención, tiene un despliegue de referencia en un laboratorio nacional; los arquitectos pueden citar a Oak Ridge en la revisión de diseño. Tres: el modelo de acceso — multitenant, Slurm y Kubernetes lado a lado, capacidad vendida en horas-nodo con mínimos y plazos — es la gramática de la nube aplicada a hardware soberano, y la copiará toda institución que posea más máquina de la que usa.
Y cuatro, el punto más silencioso y más grande: un sistema del TOP500 cuya segunda mayor asignación es una oferta comercial cambia lo que «capacidad» significa para todos los demás. Una empresa que necesita 175.000 horas-nodo de cómputo clase MI355X bajo controles DOE Moderate ya no tiene que construir, pedir prestado ni esperar. Tiene que escribir una propuesta y un cheque. Lux debutó en el n.º 14 del TOP500. Su verdadero debut es como plano: de cómo se construirán, se conectarán en red y se venderán las fábricas de IA.
𝐂𝐎𝐍𝐒𝐈𝐆𝐔𝐄 𝐋𝐀 𝐑𝐄𝐕𝐈𝐒𝐓𝐀 𝐂𝐎𝐌𝐏𝐋𝐄𝐓𝐀 𝐆𝐑𝐀𝐓𝐈𝐒 𝐄𝐍 thebuyerspulse.com/es/
Fuentes
- HPE (comunicado de prensa, noviembre de 2026): «HPE-built Lux AI cluster debuts at No. 14 on the TOP500» — codiseño y co-construcción con AMD para ORNL; HPE ProLiant Compute XD685 con refrigeración líquida directa; switches QFX de HPE Juniper Networking con soporte de 800G, balanceo de carga avanzado y gestión de congestión; HPE Networking Data Center Director (despliegue, gestión y automatización del ciclo de vida basados en intención); primera implementación de soluciones HPE Networking en un laboratorio nacional del DOE; inversión en especie de HPE de US$37 millones; Trish Damkroger, vicepresidenta sénior y gerenta general de HPC & AI Infrastructure Solutions de HPE.
- AMD (comunicado, 16 de noviembre de 2026): «AMD-powered Lux supercomputer opens to scientific users» — n.º 14 del TOP500 con 220,79 petaflops (HPL); abierto a los usuarios científicos; primera fábrica de IA dedicada de EE. UU. para la Genesis Mission; CPU AMD EPYC, GPU Instinct MI355X, red Pensando y software ROCm en un sistema construido por HPE; asignaciones de la Genesis Mission (diseño de plantas de fusión, fábrica de modelos fundacionales para materiales y manufactura avanzada, predicción del sistema terrestre para la región de la Tennessee Valley Authority); citas de Thomas Zacharia (vicepresidente sénior de Sector Público Global y Alianzas Estratégicas de AMD) y Georgia Tourassi (directora asociada de Ciencias de la Computación y Computacionales de ORNL).
- AMD (resumen de SC26, noviembre de 2026): «SC26: AMD expands frontier scientific computing» — incluido el resultado del white paper de Pelagos (herramienta abierta de AMD e IBM para decodificación de corrección de errores cuánticos), que reporta un escalado de 6,23× de 1 a 8 GPU MI355X sobre Lux.
- Oak Ridge Leadership Computing Facility (OLCF), página del sistema Lux y guía de usuario: 504 nodos × 8 AMD Instinct MI355X = 4.032 GPU; MI355X con 288 GB HBM3e a 8 TB/s; picos de 40 exaflops FP4, 20 exaflops FP8 y 317 petaflops FP64; más de 24 TB NVMe por nodo; sistema de archivos Lustre Orion de más de 600 PB; multitenant con acceso de tipo nube y planificación con Slurm y Kubernetes; 3,5 millones de horas-nodo al año, mitad para la Genesis Mission y mitad para uso propietario pagado a tarifa de user facility del DOE; compromisos de seis meses a cinco años con inicio en cualquier mes y mínimo propietario de 175.000 horas-nodo por compromiso semestral; controles DOE Moderate (el mismo nivel que Frontier), aplicaciones con control de exportación admitidas y Moderate-Enhanced (ITAR/PHI) en planes.
- Contexto (HPE y AMD, 27 de octubre de 2025): Lux anunciado junto a Discovery; Discovery sucederá a Frontier en ORNL en 2028, construido sobre la plataforma HPE Cray GX5000 con aceleradores MI430X de AMD.
- Video: Oak Ridge National Laboratory, «Inside Lux: Powering the Future of the Genesis Mission» (YouTube, canal oficial de ORNL, 2:02) — Scott Atchley, director de tecnología del National Center for Computational Sciences. Producción de ORNL, el laboratorio del DOE operado por UT-Battelle; integrado mediante el reproductor oficial de YouTube (youtube-nocookie). No se redistribuye: en LinkedIn la pieza enlaza a este artículo y al video oficial (producción del contratista UT-Battelle bajo la licencia estándar de YouTube, no dominio público).
- Foto: Oak Ridge National Laboratory, vía la página del sistema Lux de OLCF (archivo 26AH-8605, 3000×2000) — técnicos instalando y conectando los gabinetes LUX en OLCF.